|
4 u5 W2 U2 i$ z; P, u) h9 F- y+ \9 y
1. 介绍由于搜索算法本身的局限性,对于用户的语义、意图等理解不够,而基于用户行为的点击调权,作为对传统搜索算法的补充,在搜索中扮演着重要的作用尽管用户行为已经被证明在搜索中的效果,但是一直只是停留在query-url层面,或者ngram-url层面[1],没有深入反馈到检索算法中的基础策略,比如:同义词、紧密度、省略等,这些策略影响了url与query之间的关系。 ; g. b9 k9 a6 N7 V+ n7 X3 w! t
本文以对同义词的反馈为例,提出一个通用的基于用户行为的基础策略反馈框架由于同义词词典与线上应用算法的限制,检索系统中存在部分质量不好、或者本来质量好但是应用时错误降低了权值的同义词在同义词召回出来结果后,呈现在用户面前,用户的行为数据可以帮助我们识别同义词的好坏。 I5 ?6 q: r( ?! J* L/ o
在计算出同义词的好坏后,就可以直接应用于同义词的退场或者调整应用的权值2. 反馈框架 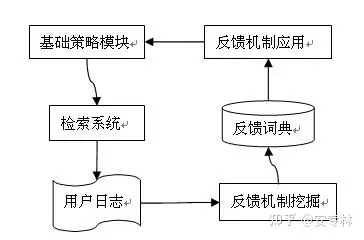 & [: J- q& r( s& i5 \' E 在进行反馈机制的挖掘中,主要分为三部分:1) 日志记录主要进行基础策略用户行为的记录、以及query-url对进行用户行为数据的统计,解决如何利用用户行为衡量query-url转义问题这部分还要记录影响具体query-url的策略,比如,这个url是哪个同义词所召回,或者是哪个term被省略。 9 g1 F& ]7 D- f0 R; @
2) 反馈机制挖掘根据query-url中统计的基础策略的用户行为数据,进行基础策略的统计这个地方不同的基础策略的衡量方式可以保持相同,但是基础策略提取的信息不一样比如同义词是替换对,省略是指省略的term等。
2 \* e, `% d" F/ J7 a3 [ 3) 线上反馈应用将第二步挖掘的词典,应用于具体的query,比如进行上下文的匹配,以及一些应用策略以上的框架比较笼统,下面针对同义词的反馈做具体的讨论3. 日志记录及统计这部分首先需要记录具体的策略,比如在这个query下,每条url是由哪个基础策略所影响的,而且需要更加具体。
! W7 }2 E! ?! v. B/ R# W 比如同义词需要记录由那些具体的同义词所召回因为往往一个query有很多同义词,但是真正每条url只是其中1到2个同义词影响的衡量query-url是否转义是非常关键的步骤,本文主要篇幅是讨论这个衡量的方法需要借助用户的行为。 . O. h& A# r+ Y6 W! j+ K* e+ k
在搜索引擎的日志系统中,对query-url有如下的用户行为统计量:(下面的讨论中,url的统计都是和query相关的,不再特殊说明)展现次数:用户搜索后,搜索引擎返回的url在前k条展现的次数(display) & J2 |( {* f0 f5 W
点击次数:用户点击url次数(click)满意点击次数:考虑是否满足用户的需求的点击(相对停留时间,是否是最后点击) (satisfy)因此我们可以用click/disply、satisfy/display来衡量url的好坏。 9 }$ v N, ` {: `9 r
但有如下问题:1.位置偏置问题:点击次数对位置非常敏感,搜索结果中, url的点击次数随着url的排序位置越靠后,其点击次数越少,而且越后面减少得越快因此位置在前的url,虽然转义了,但也有很多用户点击;反之,位置在后的url,虽然满足用户需求了,但也很少有用户点击。
" [. u3 } Z* b7 e) X& { 这样很容易让我们的反馈系统失效2.在搜索引擎中,用户对搜索结果的满意大致可以分为两个层次:1) 检索出来的url的标题和摘要是否和用户的query的意图一致2) url内容的质量是否满足用户的需求,比如是否死链、知道页面没有人回答、作弊页面等。 7 Q+ F Z& b) I! o, H
我们的目标是识别出转义的替换词对,这些只和第1个层次的满意相关我们可以假设用户既然点击了这个url,说明这个url的title摘要是没有转义的,至于网页的质量不是同义词本身的质量所能影响的为了解决问题1,可以从这一角度考虑。 9 l! F* N' N' O+ _) a+ ^ U2 J
排在后面的url点击次数少的原因是用户看到的次数少,因此不能用展现来与click做比值,可以利用一些方法来估计用户看到的次数,我们称之为检查次数(check)这里有一些很简单的方法比如对于每次用户的搜索,用户最后点击的url位置为p,那么位置在p之前url检查次数是1,在p之后的url的检查次数依次以一个概率衰减。
4 @' c+ r" @' u5 u3 {* \, U 这些概率可以采用一些贝叶斯的方法进行学习[2]采用检查次数可以部分解决位置偏置问题,但是学习到的衰减参数是对所有的query-url,但不同的query-url有很大的差别,这也是该方法的不足之处4. 反馈挖掘和应用。
/ n6 L" W8 @0 Q2 G) c( P 4.1 反馈挖掘基于第3章中日志记录的工作,可以采用click次数用来表示url满足query的次数,而check-click表示url不满足query的次数这样用click/(check-click)这个值来表示url满足query程度。
$ j. [# u" }1 F4 T 对于具体的同义词反馈任务,可以把多条query-url结果中记录的同样的同义词替换进行统计click和check次数(即统计的key是 原词 替换词 二元组),把最后得到的click/(check-click)作为衡量这个同义词替换的相似度,即同义词的反馈替换相似度:。 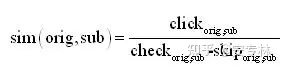 - q# o. X" U* \3 y 这个地方还有一大问题是,由于很多同义词是上下文相关的,比如:考虑一对同义词 看->治疗,在某些上下文下,比如:哪里看病比较好,是同义的;而在某些上下文下,比如:哪里看还珠格格连播因此为了更智能的在不同的上下文进行同义词的反馈,需要在统计的时候考虑上下文,即统计的key为:原词 上下文 替换词 三元组。 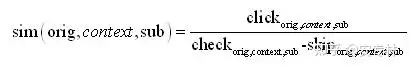 # w; {" t$ f/ \1 Y 但是不能把整个query作为上下文,这样统计会有很大的数据稀疏性,而如果随便把单个词作为上下文,会有很大的准确率问题比如 哪里 对 看->治疗 以及看->观看 都是支持的因此为了兼顾上下文数据的稀疏以及准确问题,需要一个上下文选择算法。
1 C2 @$ V% E% r+ Z 在自然语言处理中通常采用似然比的方法(llr, likelihood ratio)[3],用来衡量orig与context的搭配强度,从而搭配强度越强,这个context词可以认为是orig词的替换上下文。
" V. T. h0 T# p# @4 n; {1 F 其计算方法为: 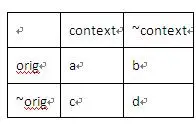 9 _$ `1 ?; y/ d s. u 其中a表示orig,context共现次数;b表示orig出现,context不出现的次数;c表示orig不出现,context出现的次数;d表示oirg和context都不出现的次数N=a+b+c+d表示总共的样本数,那么llr的计算公式为:。  & L0 c9 i4 {; o6 P 4.2 反馈应用反馈机制应用时,是针对每一个替换进行独立的判断,即已知替换对(orig sub),需要先进行上下文的选取上下文相关的同义词,本质上来说被替换词是一个多义词,对于大部分query来说,只用一个上下文词就可以限定被替换词的意义。
8 @: ]6 K4 o2 h2 k* P+ I 因此从简单的角度考虑,以及多个词的上下文融合所带来的噪音以及融合方式的问题,反馈机制应用时只选择一个在一定上下文窗口内的词语最后计算所选择的上下文,利用4.1节中训练的数据,作为替换的反馈相似度,即sim(orig,contex,sub)。 , _5 Z4 v8 ], G
利用这个值作为同义词的置信度应用于线上:或退场,或降权,或升权5. 总结和展望在检索系统中,对基础策略做基于用户行为的反馈是一个比较新的方向,对于改进基础数据具有非常重要的意义本文根据对用户行为的深入调研,探讨了一些方法和指标。 1 A9 {9 d7 M; S) q, |2 y$ r" H
从总体上来说,本框架的相当于做了两个假设:用户行为与相关性的关系正相关,url相关性与基础策略正确性正相关第一个假设涉及到基础统计特征的调研思考角度点击检查是体现这些关系的特征之一,另外还可以考虑更多的特征,比如:满意点击,点击的url条目。 . H8 l2 T# Z. t
还有飘红对点击的影响,用户的作弊识别等干扰基础特征的统计这一点不同的基础策略是可以统一的第二个假设涉及到基础策略以什么形式来表示这些基础的统计特征这个是和基础的策略紧密相关比如同义词选择上下文的方法,以及上下文的位置,多个上下文,或者不需要上下文的替换对识别等。
B2 N6 {6 Y! f1 K z% u+ s+ q* c 另外还需关注基础策略的应用问题,比如同义词不转义,url转义的问题,这对基础策略的识别会产生误导从机器学习的角度上,该方法主要从生成模型的角度出发,因此模型的各个步骤解释性很强,但是无法利用更多的特征,可以挖掘更多的特征并采用机器学习的方法来利用这些特征。 ! J2 m4 t7 T8 l) w0 v0 ~+ n
6. 参考文献[1] Huihsin T, Longbin C, Fan Li etc. 2009. Mining Search Engine Clickthrough Log for Matching N-gram Features . Proceedings of the 2009 Conference on EMNLP, 524-533.
& q2 H* ~8 E/ T w [2] Ricardo Baeza-Yates, Carlos Hurtado,etc. Modeling User Search Behavior. In LA-WEB 05[3] Christopher D. Manning, Hinrich Schutze. Foundations of Statistical Natural Language Processing. The MIT Press. 172-175
5 y; l; P1 N% y+ g- G! h6 ] 文章来源:百度搜索研发部博客 - \. E( {$ {& I/ u) }* Q9 X
9 k, h4 @& X" A0 y2 Q: G- l2 V
5 e' a, l* z. ^2 ?; H+ Q: i2 i
6 i# k+ T) L& T, H) C) V
# _- T; q/ u+ v% T' | |