|
& t/ g8 U' l# n' n
在日常工作中,我们经常会用到mysql的索引使用索引的目的基本上就是为了在大量的数据中快速找出某个在日常工作中,我们经常会用到mysql的索引使用索引的目的基本上就是为了在大量的数据中快速找出某个列中一个特定值的行,简单说就是提高查询效率。 # H% V1 Y+ ]) j6 D& |$ G( B
使用索引的优点:可以快速检索,减少I/O次数,加快检索速度;根据索引分组和排序,可以加快分组和排序当然索引也有缺点:索引是数据结构,索引是存储在表中的,创建索引和维护索引需要时间,而且数据量越大时间越长。
+ M! V; h# E: j8 w 创建索引需要占据磁盘的空间,如果有大量的索引,可能比数据文件更快达到最大文件尺寸当对表中的数据进行增加,修改,删除的时候,索引也要同时进行维护,降低了数据的维护速度索引的分类:常见的索引类型有:主键索引、唯一索引、普通索引、全文索引、组合索引 9 f4 O; P$ A) n: J2 t. O5 |
普通索引(Normal):基本索引类型,允许在定义索引的列里插入空值或重复值唯一索引(Unique):索引列值必须唯一,但允许有空值如果是组合索引,则列值的组合必须唯一主键索引是一种特殊的唯一索引,不允许有空值。
, T& e* h" W# r2 _% h 单列索引:只包含一个列的索引,一个表中可以有多个组合索引:包含多个列的索引,查询条件包含这些列的最左边的字段的时候,索引就会被引用,遵循最左缀原则全文索引:用大文本对象的列构建的索引索引的设计原则:首先索引并不是不是越多越好,而且对于常更新的表索引越少越好。
, s3 p+ L* x- e9 p 数据量小的表最好不要建立索引不同的值比较多的列才需要建立索引某种数据本身具备唯一性的时候,建立唯一性索引,可以保证定义的列的数据完整性,以提高查询熟度频繁进行排序或分组的列(group by或者是order by)可以建立索引,提高搜索速度 / y! T7 n- g0 U3 h+ r1 y. `2 z( ~9 u
经常用于查询条件的字段应该建立索引索引需要占用磁盘空间,因此在创建索引时要考虑到磁盘空间是否足够而且创建索引时需要对表加锁,因此实际操作中需要在业务空闲期间进行索引的实现原理:Mysql本身支持多种存储引擎,所以可以支持多种索引。 / Y3 R+ }4 \" {
如BTree索引,哈希索引,全文索引等mysql默认存储引擎innodb只显式支持B-Tree( 从技术上来说是B+Tree)索引,对于频繁访问的表,innodb会透明建立自适应hash索引,即在B树索引基础上建立hash索引,可以显著提高查找效率,对于客户端是透明的,不可控制的,隐式的。
o( N1 D- `: u# N' T; [* r B+树索引是B+树在数据库中的一种实现,是最常见也是数据库中使用最为频繁的一种索引B+树中的B代表平衡(balance),而不是二叉(binary),因为B+树是从最早的平衡二叉树演化而来的二叉树具有以下性质:左子树的键值小于根的键值,右子树的键值大于根的键值。
" S7 q: A# W" Z, c! j 比如: 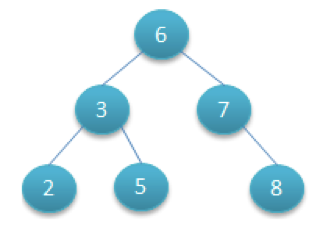 J1 g; X- C5 @! _ K 对该二叉树的节点进行查找发现深度为1的节点的查找次数为1,深度为2的查找次数为2,深度为n的节点的查找次数为n,因此其平均查找次数为 (1+2+2+3+3+3) / 6 = 2.3次但是显然对于这种:  / `+ a6 C2 k' c8 J 对这种二叉树而言查询效率就要低很多,特别是查找最底层的叶子节点的时候所以要想要这个二叉树的查询效率高,就得需要这棵二叉树尽量是平衡的对于平衡二叉树而言,他不仅满足二叉树的性质,而且还满足任何节点的两个子树的高度最大差为1。
+ M4 q9 p% O1 e0 M- x: y& W 比如:  " q2 c! a0 ~0 ]9 \( }+ k BTree是平衡搜索多叉树,是为磁盘等外存储设备设计的一种平衡查找树系统从磁盘读取数据到内存时是以磁盘块(block)为基本单位的,位于同一个磁盘块中的数据会被一次性读取出来,而不是需要什么取什么InnoDB存储引擎中有页(Page)的概念,页是其磁盘管理的最小单位。 / x+ y5 ^! M7 O8 D& G) o! g$ F
Innodb默认每页大小为16k而系统一个磁盘块的存储空间往往没有一页那么大,因此InnoDB每次申请磁盘空间时都会是若干地址连续磁盘块来达到页的大小InnoDB在把磁盘数据读入到磁盘时会以页为基本单位,在查询数据时如果一个页中的每条数据都能有助于定位数据记录的位置,这将会减少磁盘I/O次数,提高查询效率。 8 M5 s. z9 T1 M8 S5 c' s
BTree结构的数据可以让系统高效的找到数据所在的磁盘块B树是一种多路自平衡搜索树,它类似普通的二叉树,但是B树允许每个节点有更多的子节点有如下特点所有键值分布在整个树中任何关键字出现且只出现在一个节点中。
0 S5 b. j3 K2 e% T0 q+ Y 搜索有可能在非叶子节点结束在关键字全集内做一次查找,性能逼近二分查找算法如下图所示为一个3阶的B-Tree  8 ^! j# o) V' M( e& s L 打开凤凰新闻,查看更多高清图片比如要查找位于磁盘8上的28 从根节点开始先找到磁盘1,读入内存,通过比较关键字28找到磁盘1的指针p2在根据p2找到磁盘3,读入内存,再通过比较关键字找到磁盘3上的指针p2.根据p2找到磁盘8读入内存,通过比较找到关键字28.由于根节点常驻内存,整个过程只是进行了2次的磁盘io操作。
% B" L3 }3 V; f6 ~- z B+树是在btree基础上进行的一种优化区别如下:B+Tree中的非叶子结点不存储数据,只存储键值;B+Tree的叶子结点没有指针,所有键值都会出现在叶子结点上,且key存储的键值对应data数据的物理地址。
2 Y+ j; ?( Y# b; r5 w! } 结构图如下:  7 ~( i2 d8 F: @- r/ z D4 z* j Mysql默认innodb存储引擎就是使用B+树来实现索引结构的由于内节点(非叶子节点)不存储data,所以一个节点可以存储更多的内节点,每个节点能索引的范围更大更精确也就是说使用B+树单次磁盘IO的信息量相比较B树更大,IO效率更高。
- J7 O) _2 I( T3 _ I 一般实际应用中,度d是非常大的数字,通常超过100,因此h非常小(通常不超过3,也即索引的B+树层次一般不超过三层,所以查找效率很高) - S6 X+ [/ a6 Q0 G2 q1 [
0 }$ J0 l7 \$ v! P5 F
( H" `" i0 y9 {! n
0 m1 K. A: Y9 V+ K4 @8 L4 ]* j9 l9 n7 V; F
| 


 7 ~( i2 d8 F: @- r/ z D4 z* j
