|
S- G" E5 K1 l; g: Q- P [ 前端的页面性能优化是每个前端工程师都逃脱不了的话题,因为用户体验是我们永恒的目标这篇文章我会从性能指标出发,在网络资源优化和页面渲染优化这两个角度,总结一下个人对前端页面性能优化的相关知识的学习和实践 本文首发于我的技术博客:
# }4 q4 `' O' k7 I; w B& Q 前端页面性能优化总结 封面图片:Photos provided by Pexels性能指标的建立和解读首先要明确性能的一个度量是神马也就是说要有一个数据的对比,做性能优化之前,我的页面性能是多差,做个之后我又提高了多少。 0 F8 L( T& Q2 F
那这个数据怎么采集呢?下面说一下两种方式 Web Navigation Timing API 如果我们想自己采集页面的各项原始指标数据,该怎么做呢?浏览器为我们提供了原生的 Timing API,并且现在有两个标准,下面来分别介绍一下这两个标准。
9 @# B9 V2 a1 O( L9 C Navigation Timing Level 1 window.performance.timing 在没有这个API之前,如果我们要收集完全加载页面所需的时间,可能需要这么做:
6 q Y9 r1 a. Z# [2 i >varstart=newDate().getTime();functiononLoad(){varnow=newDate().getTime p/ n* f; ]$ ~ J8 H: x3 y8 M3 s
();varlatency=now-start;alert("page loading time: "+latency);} : D {: Y# Q: P) v) E) f
上面的脚本计算了 head 中的第一个 js脚本执行后加载页面所需的时间,但它没有给出任何关于从服务器获取页面所需的时间,或是页面初始化生命周期的信息。 % N K5 @& X) V# H
为了准确可靠的获取可用于衡量网站性能的数据,window.performance.timing 可以获取以前难以获取的数据,例如卸载前一页所需的时间、域查找所需的时间、执行窗口加载处理程序所花费的总时间等。 + Q7 o; D. J: O6 \. O2 n2 U
下面这张图展示了window.performance.timing的各个属性,以及其对应的各个页面阶段 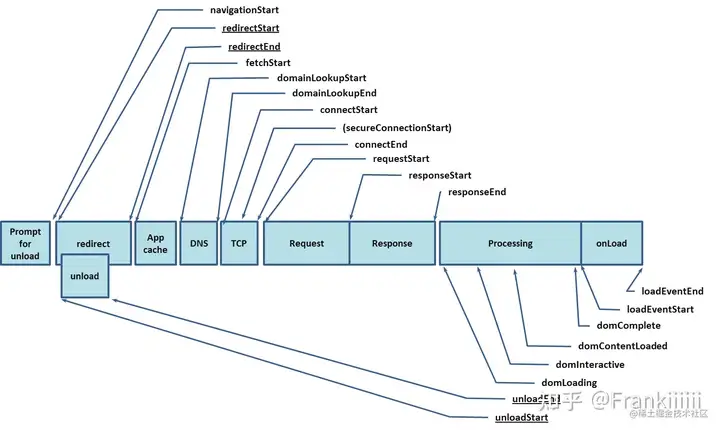 3 t. t, f6 W* [" d: U/ G: Z 由此我们可以计算旧文档的卸载、重定向、应用缓存、DNS lookup、TCP 握手、HTTP 请求处理、HTTP 响应处理、DOM 处理、document加载完成等页面性能打点具体可以参考navigation-timing W3C的规范。
& {$ V; L# F/ V5 k k( f! e/ h 和 几个页面关键指标是如何计算的 window.performance.navigation PerformanceNavigation接口呈现了如何导航到当前文档的信息用来描述页面加载相关的操作,共有两个属性。
F2 S& Y Q7 S type和redirectCountNavigation Timing Level 2 Level 2标准废弃了level 1的timing和navigation这两个接口,取而代之的是定义了 PerformanceNavigationTiming 对象,该对象可以这样获取:。
- O" A, x1 ~- l8 _: a; w& a3 U window.performance.getEntriesByType("navigation")[0]; Level 1接口的属性值是基于 JavaScript 的 Date 对象,而Level 2 使用
1 H1 h5 `) Y1 q( [0 _# d; Q High Resolution Time 解决了时间精度的问题并且Level 2的Navigation Timing API也更新了Processing Model,扩展了PerformanceResourceTiming 接口,可以获取更加详细的打点信息。 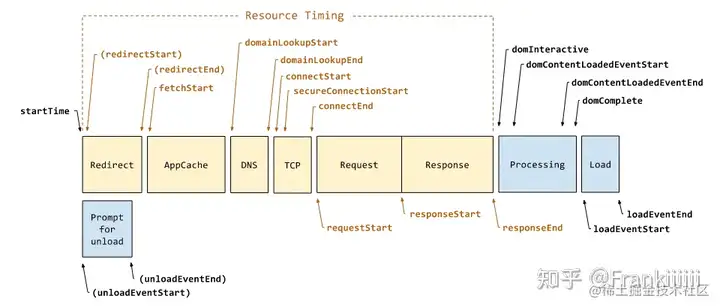 7 _5 [; y7 Q2 \/ y5 ] 从上图中我们可以看出Document Processing是 Navigation Timing 独有的,后面我们也会介绍Resource Timing整体而言 Level 2 标准更加的全面,把Web Performance Timing分成了各个 。
$ @5 }1 J/ X4 _* @0 ~* j Performance Metric,看起来一目了然,然而各个主流浏览器还存在兼容性问题 介绍完这两个Performance Navigation Timing API,我们顺便再来看一下其余几个主要的Performance Timing API:Resource Timing API 、 Paint Timing API 和 Long Task Timing API,以及如何使用PerformanceObserver异步获取性能数据。
) o1 C/ T# C6 X0 {9 @ window.performance.getEntriesByType("resource") PerformanceResourceTiming 接口支持检索和分析有关应用程序资源加载的详细网络计时数据,我看可以此来确定获取特定资源(例如 XMLHttpRequest、、图像或脚本)所需的时间长度 # v) [9 ]* a% A# q
window.performance.getEntriesByType("paint") PerformancePaintTiming 接口在网页构建期间提供有关“绘制”(也称为“渲染”)操作的耗时信息。 ; u! r; C2 p& C; k0 J- M! {2 g$ Y
first-paint:从导航开始到浏览器将第一个像素渲染到屏幕的时间(白屏耗时)first-contentful-paint: 浏览器渲染来自 DOM 的第一位内容的时间(FCP) PerformanceLongTaskTiming。 ! l& q7 }! ^* t# A+ e
Long Tasks API 可用于了解浏览器的主线程何时被阻塞了过长时间从而影响了帧速率或输入延迟目前,API 将报告任何执行时间超过 50 毫秒的任务 使用 PerformanceObserver 监听以上介绍的性能指标。 % Y( v( ]. C. j* U5 C8 \/ @& {$ e" ~
// Instantiate the performance observer8 M) ~& D9 J& V+ M6 f# E
varperfObserver=newPerformanceObserver(function(list,obj){// Get all the resource entries collected so far
$ u$ ]+ L* k4 s2 J7 | 8 ~2 T& s; p( b: R
// (You can also use getEntriesByType/getEntriesByName here)
5 _/ T, G! {9 y: W4 I2 E varentries=list.getEntries();// Iterate over entries
( Q+ \6 F2 G5 ]; F: d: q 9 Y( |1 I x# U- j2 G: l1 T) r
});// Run the observer. g5 L+ {) t2 l7 w
perfObserver.observe({// Polls Timing entries
" J6 v6 o$ \, ? entryTypes:["navigation","resource" 5 Y; d r' [# u7 T# ?. R
,"longtask"]}) erformanceObserver 可以被动地订阅与性能相关的事件,也就是说这个 API 通常不会干扰页面主线程的性能,因为它的回调通常在空闲期间触发默认情况下,PerformanceObserver 对象只能在条目出现时观察它们。 1 c5 K! }! v6 m9 r' r' K5 ^
如果想延迟加载性能分析代码(不阻止更高优先级的资源),我们需要这么做:// Run the observer
4 M9 U7 q/ h9 r+ T perfObserver.observe({. E6 p1 k: i g m
// Polls for Navigation and Resource Timing entries
4 Y Z5 H# k; u, A6 J u& F entryTypes: ["navigation", "resource"],
e$ Q2 L% r8 C' B( G$ p8 I# R3 g // set the buffered flag to true
8 [0 d; t4 D) c# |* I( ^. x buffered: true,
% E3 @/ H$ q; C: M2 Y& Q1 J. f });
$ L( g4 [ n5 _/ W) L$ [, y# f 设置buffered 为true,浏览器将在第一次调用 PerformanceObserver 回调时返回其性能条目 缓冲区中的历史条目 Web Vitals Web Vitals 是 Google 的一项举措,旨在为web质量提供统一的指导,这些指标对于在网络上提供出色的用户体验至关重要。 " \8 H0 o1 t3 B
Web Vitals为了简化场景,帮助网站专注于最重要的指标,提出了Core Web VitalsCore Web Vitals 是 Web Vitals 的子集,包含 LCP(Largest Contentful Paint),FID(First Input Delay) 和 CLS(Cumulative Layout Shift)。 + n( h9 B S/ T1 m2 m, T
LCP(Largest Contentful Paint):最大内容绘制,测量加载性能为了提供良好的用户体验,LCP 应在页面首次开始加载后的2.5秒内发生FID(First Input Delay):首次输入延迟,测量交互性。 2 J1 F/ F) E. l; y/ E( l
为了提供良好的用户体验,页面的 FID 应为100毫秒或更短CLS(Cumulative Layout Shift):累积布局偏移,测量视觉稳定性为了提供良好的用户体验,页面的 CLS 应保持在0.1或更少。 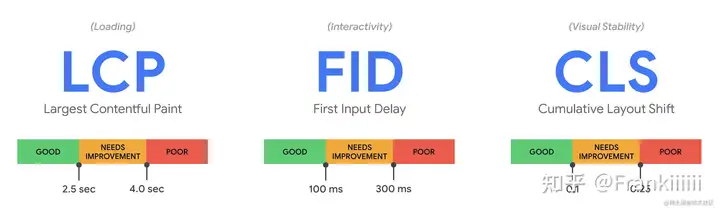 4 T6 w- H& A1 O 从这三个指标的含义中我们可以发现这三个指标分别从页面的加载速度,页面的交互性和页面的视觉稳定性这三个角度来衡量页面的性能 那么如何采集这些指标呢?谷歌提供了一个大约只有1k大小的web-vitals库。 4 {# E! {! F3 {
用这个库,我们不仅可以采集到前面提到的三个指标,还可以采集到First Contentful Paint (FCP) 和Time to First Byte (TTFB)具体使用请移步web-vitals。
5 u- @; g( r) s, ?, \ 网络资源优化 网络资源优化可以分网络的优化和资源的优化,先说网络层面的优化CDN CDN 即内容分发网络CDN服务提供商将源站的资源缓存到全国各地的高性能加速节点当用户访问相应的服务资源时,会将用户调度到最近的节点,并将最近的节点IP返回给用户,使用户就近获取所需内容,从而可以更快、更稳定地传输内容。
( p0 n0 {8 q2 _ CDN 的核心点有两个,一个是缓存,一个是回源:缓存: 将源服务器请求来的资源按要求缓存回源:CDN节点没有响应到应该缓存的资源(没有缓存过或者是缓存已经到期),就会回源站去获取 HTTP & TCP HTTP应用层的优化和TCP传输层的优化是前端性能优化的必经之路。 8 v5 P; i2 U: [3 R% ]
我们都知道合并(减少)静态资源的HTTP请求(比如前端雪碧图)是一条前端优化准则,那它背后的原理是什么呢?真的要严格做到减少HTTP请求吗?下面我们从原理上探下究竟 HTTP/1.1的缺点 HTTP/1.1 队头阻塞的问题 2 |6 S% u1 ?6 ]7 x) e
我们都知道在HTTP/1.1中使用了持久连接,虽然可以共享一个TCP管道,但一次只能在管道中处理一个请求在当前请求结束之前,只能阻止其他请求也就是说如果某些请求被阻止10秒,则后续排队的请求将延迟10秒。
% q# a `/ _+ N- ?( n 这个队头阻塞问题使得这些数据请求不能并行进行这也就是为什么浏览器可以为每个单独的域名支持多条 TCP 连接(最多6个),请求可以分布在这些单独的连接上,起到并行请求处理的效果 TCP 慢启动 TCP慢启动是TCP拥塞控制的一种策略。
+ U% \/ y' W+ _9 f. `( i' U TCP 在刚建立连接完成后,首先是有个慢启动的过程,这个慢启动的意思就是一点一点的提高发送数据包的数量当发送方每收到一个 确认包,拥塞窗口的大小就会加 1说慢启动会带来性能问题就是因为如果请求一个不大的页面关键资源也要经过这样的慢启动过程,那么页面的渲染性能就会大大的降低。
( L7 F3 x/ A( V q% Z 所以从HTTP 1.1的缺点上看,我们一开始提到的前端雪碧图是很有必要的一个 TCP 连接同时只能处理一个 HTTP 请求所以在网站资源较多,加上浏览器有TCP连接数量的限制时,页面加载就会比较慢,这时将一些小图片合并成一个大的图片,从而减少 HTTP 请求是十分可取的。
6 J. l( T. Q$ F& U HTTP/2的优点和缺点 多路复用(核心优点) HTTP/2 采用了多路复用机制 HTTP/2 通过引入二进制分帧层,浏览器会将每个请求转换为多个带有请求 ID 编号的帧,服务器接收到所有帧之后,会将相同 ID 的帧合并为一条完整的请求,处理完请求后,又把响应转换为多个带有响应 ID 编号的帧,浏览器会根据 ID 编号将帧的数据合并。
+ e- h. D/ r2 L( }( U 通过这样的机制,HTTP/2 实现了资源的并行传输并且,加上HTTP/2 的一个域名只使用一个 TCP 连接,这样就解决了的HTTP/1.1的队头阻塞问题,同时也可以解决多条 TCP 连接导致的竞争带宽问题。 0 E& s" | s$ ^: C: ~
再说说之前提到的前端雪碧图现在我们知道了在 HTTP/2 中,多个请求不再是一件很耗费性能的事情前端雪碧图相比于从图片格式和大小(webp等)优化出发,明显后者更能产出性能优化所以在 HTTP/2 中,前端雪碧图不再是一个最佳实践。
4 y6 s6 I# B" x7 }; {' [- G6 Y 其他优点基于二进制分帧层,HTTP/2 还可以设置请求的优先级,这样就解决了资源的优先级问题服务器推送,不用浏览器去主动请求页面的关键资源,一旦HTML解析完之后,就可以拿到关键渲染路径上的资源头部压缩。 5 k1 i5 f0 W" Q' I8 }3 I
HTTP/2 对请求头和响应头进行了压缩 缺点:HTTP/2 的 TCP 队头阻塞问题 HTTP/2 解决了应用层面的队头阻塞问题,并没有改动到跟HTTP /1.1 相同的TCP传输层协议我们知道TCP 是一个保证可靠的面向连接的(一对一的单连接)通信协议,如果有一个数据包丢失或者延迟了,那么整个 TCP 的连接就会处于暂停状态,需要等待重新传输丢失或者延迟数据包。
K' I, O8 Z7 {6 b4 ` 但是,在HTTP/2 中一个域名又只使用一个 TCP 连接,一个一个请求是跑在一个 TCP 长连接中的,如果其中一个数据流出现了丢包的情况,那么就会阻塞该 TCP 连接中的所有请求,进而影响了HTTP/2 的传输效率。 ' R% ^2 Z0 X4 i' r) n4 R
HTTP3的展望 QUIC 协议 HTTP/3和HTTP/2主要区别在于 HTTP/3 基于 QUIC 作为传输层来处理流,而 HTTP/2 使用 TCP 来处理 HTTP 层中的流 可以把 QUIC 看成是集成了“TCP+HTTP/2 的多路复用 +TLS ”的一套协议。
3 Y" P4 f7 a. A3 V; R1 S! ` 其中的快速握手功能(基于UDP)实现了使用 0-RTT 或者 1-RTT 来建立连接,可以大大提升首次打开页面的速度但是,目前HTTP/3 的浏览器兼容性存在问题,Safari浏览器默认不支持该功能 Preconnect & DNS-Prefetch
$ ]6 B/ w k1 x+ f preconnect和dns-prefetch都是资源探嗅(resource hints)的标准,用法如下:
: ~) c: A6 j4 o9 ]/ G! s+ o! ^
4 b ?! f9 f- ^( O # X& y4 l% X' [" [% \' u( D
preconnect可以用在请求资源前,预先完成 DNS lookup + TCP handshake + TLS handshake(如果是https),当客户端需要请求目标资源的时候,下一个 TCP 首包就可以直接发送 HTTP 请求。 9 I; t( }& H/ q# r5 y, ]
虽然非常简单,但它仍然会占用宝贵的 CPU 时间,尤其是在安全连接上 如果在 10 秒内没有使用连接,浏览器会关闭它,这样就浪费所有早期的连接工作目前Safari 11.1版本以上的浏览器都支持,但是较新的几个Firefox浏览器版本都不支持。 ) d. L) z/ k$ y: i9 y/ |
dns-prefetch的浏览器兼容性比较好,但是它只处理了DNS查询 资源本身优化 我们来看一下几个常见资源的大小优化,其实这些资源基本上都可以在webpack打包阶段进行优化,当然有些压缩也可以在http层面进行。 & d: {4 c/ |5 D$ M5 c7 K
html 首屏HTML需要控制在14kb内,不然会增大RTT,影响首屏渲染的时间webpack 插件html-webpack-plugin有个minify:true 的配置可以开启html的压缩还有就是不要滥用内联CSS样式和JS脚本。 % S* A% J! e v$ r
JS 重点来介绍一下借助webpack我们可以做哪些酷炫的事情 scope hoisting scope hoisting 翻译过来就是作用域提升在webpack中,这个特性被用来检测引用链(import chaining)是否可以被内联,从而减少没有必要的module 代码。 ; { Q! W& Z: {* F0 a
在webpack中开启ModuleConcatenationPlugin插件可以开启scope hoisting此插件只在 production mode生产环境中默认开启如果想了解更多scope hoisting的分析可以看我的另一篇文章:。
& h8 B/ m9 _: t9 S; G! o) w 浅析webpack的scope hoisting code splitting webpack的code splitting能够把代码分离到不同的 bundle 中,然后可以按需加载或并行加载这些文件代码分离可以用于获取更小的 bundle,减少文件加载的耗时。
- k* e: O. L4 P 常见的方案有:开箱即用的SplitChunksPlugin配置可以做到自动拆分 chunks动态导入(dynamic import)可以做到代码的按需加载关于webpack动态导入的分析可以看我的另一篇文章:。 + C* a9 N7 k6 B( `, \3 q3 J
分析 webpack 动态import的实现使用 entry 配置可以配置多个代码打包入口点,从而做到手动地分离代码 tree shaking Tree shaking是一个用在js中删除无用代码的术语。
/ j# F4 f* P* _4 h; r 在webpack 2版本中webpack内置支持了ES2015 modules,并且也支持了无用模块的导出检测webpack 4版本在此功能上进行了扩展,并通过在package.json 中添加 “sideEffects” 属性向编译器提供提示,以标示项目中的哪些文件是“纯”的,从而可以安全的移除。 / k2 d+ [( ]# s! n* H
关于webpack tree shaking的深层次分析和目前的不足,可以看我的文章:探究webpack的tree shaking minify webpack4+会在生产环境下默认使用 TerserPlugin
- s, _/ m0 o; c) L6 t 进行代码压缩 CSS 内联首屏关键CSS 内联首屏关键CSS文件,可以提高页面的渲染时间因为CSS会阻塞JS的执行,而JS会阻塞DOM的生成,也就是会阻塞页面的渲染,那么css也有可能会阻塞页面的渲染一些CSS-in-J的方案,比如styled-components 也是critical CSS友好的,styled-components会跟踪页面上呈现的组件,并完全自动地注入它们的内联样式,而不是一些CSS link。
# v$ N: a" \1 Q! b2 A0 V: Z 结合组件级别的代码拆分,可以按需加载更少的代码 动态异步加载CSS 对于大的 CSS 文件,可以通过媒体查询属性,将其拆分为多个不同用途的 CSS 文件,这样只有在特定的场景下才会加载特定的 CSS 文件。 . }/ P% Q! `3 e; m
CSS文件压缩 可以使用webpack的mini-css-extract-plugin开启CSS的压缩 图片压缩 webpack的img-loader 可以支持不同格式的图片压缩插件当然如果图片很小我们也可以考虑内联base64图片(。
1 K3 e& T; o4 U& l3 \ url-loader) http层面的资源压缩 主要使用了content-encoding这个实体消息首部,用于对特定媒体类型的数据进行压缩借助nginx配置,我们就可以实现:# 开启gzip 压缩
3 o* ?( E% L. V0 } gzip on;. J: _. @7 Z8 f/ v5 m. W
( |3 L9 M" C+ p) a% [0 z, D # 设置gzip所需的http协议最低版本 (HTTP/1.1, HTTP/1.0)9 y! G9 Z2 B5 H
gzip_http_version 1.1;
2 M7 z/ c5 X3 u! A! u0 U
) {0 h. D1 l" Z+ K/ K # 设置压缩级别,压缩级别越高压缩时间越长 (1-9)- p1 T0 N; c' h' b6 E
gzip_comp_level 4;" X9 \9 S5 A. ~# J
( r# W7 Q- n' u, b. g # 设置压缩的最小字节数, 页面Content-Length获取
P2 c) }2 b7 P" {8 L: T( t gzip_min_length 1000;0 G7 ]9 U# E: h3 E
5 D* N! A6 j$ K; d$ w5 ]
# 设置压缩文件的类型 (text/html)
3 d* K" M/ F1 J, L2 K( H3 W gzip_types text/plain application/javascript text/css;2 i0 \6 N/ H/ @+ P3 z2 {# b7 Y9 s
。
4 }. m% z! P& H/ V$ q. m. y 资源的缓存 HTTP缓存 强缓存 强缓存指的是在缓存数据未失效的情况下,直接使用浏览器的缓存数据,不在发起网络请求强缓存由Expires和Cache-Control两个响应头实现 Expires 它的值是一个GMT时间。 U! _9 Z& s! C1 |, z% N
该值描述的是一个绝对时间,由服务器返回Expires 受限于本地时间,如果修改了本地时间,可能会造成缓存失效 Cache-Control 主要有一下几个值:no-cache:浏览器每次使用 URL 的缓存版本之前都必须与服务器重新验证
2 p" ^. n' J3 P' L C S5 F4 o; @ no-store:浏览器和其他中间缓存(如 CDN)从不存储文件的任何版本private:浏览器可以缓存文件,但中间缓存不能public:响应内容可以被任何服务器缓存存储max-age:缓存时长,用来指定相对的时间量。 & ^; h; V/ v8 e* x- e8 j `
如果以上两个响应头一起出现那么cache-control 的优先级高于 expires 协商缓存 当浏览器对某个资源的请求没有命中强缓存,就会发一个请求到服务器,服务器会查看相关资源是否修改更新,若没有更新返回304状态码,若有修改更新,则返回最新资源和200状态码。
7 e* k- Y" B* `5 A 协商缓存是利用的是【Last-Modified,If-Modified-Since】和【ETag、If-None-Match】这两对Header来管理的Last-Modified是服务器认定的资源做出修改的时间,浏览器会在下次请求时带上作为If-Modified-Since的值,由此服务器可以做资源是否被修改的检查;ETag和If-None-Match的使用方式与Last-Modified和If-Modified-Since类似,只是ETag 的值的生成比较复杂,通常是内容的哈希值、最后修改时间戳的哈希值。
8 [, c( N7 c7 `( D. E* m ETag的优先级比Last-Modified更高 使用长期缓存 为了更有效的利用缓存,我们通常会给静态资源设置一个比较长的缓存时间,在每次打包上线,为了让浏览器获取最新的资源,我们都会给变动的静态资源改成一个跟上次不一样的版本hash文件名,如。 2 |* U* s; ~+ u. l$ A3 N5 w
main.8e0d62a03.js我们可以借助webpack打包出这样的hash文件指纹webpack有如下三种hash的生成方式:hash:和整个项目的构建相关,只要项目有修改,整个项目构建的hash值就会更改。 6 w; B! {8 E' z) m
chunkhash:和webpack打包的chunk有关,不同的entry会生成不同的chunkhash值contenthash:根据文件内容来定义hash,文件内容不变,则contenthash不变 service worker 缓存 2 Y6 Z! A3 E: R! c" S0 _' x- @
Service Worker 拦截网络类型的 HTTP 请求,并使用缓存策略来确定应将哪些资源返回给浏览器 Service Worker 缓存和 HTTP 缓存具有相同的目的,但 Service Worker 缓存提供了更多的缓存功能,例如对缓存的内容以及缓存的完成方式进行细粒度控制。 ! o( \' Y+ |0 O: d& ]/ L
下面来罗列一下几个常见的 Service Worker 缓存策略(也是Workbox提供的几个开箱即用的缓存策略)Network only:始终从网络获取最新的内容Network falling back to cache。
/ S' J9 ?8 w! \ :需要提供最新的内容但是,如果网络出现故障或不稳定,则可以提供稍微旧的内容Stale-while-revalidate:可以立即提供缓存内容,但将来应该使用更新的缓存内容Cache first, fall back to network。
; O5 ]7 b1 a+ \ :优先从缓存中提供内容以提高性能,但 Service Worker 应该偶尔检查更新Cache only:只使用缓存 stale-while-revalidate 在上面的service worker 缓存策略中我们提到过stale-while-在上面的service worker 缓存策略中我们提到过stale-while-revalidate。 ; c2 @7 {! w! {+ E; E
它其实是一种由 HTTP RFC 5861 推广的 HTTP 缓存失效策略这种策略首先从缓存中返回数据(过期的),同时发送 fetch 请求(重新验证),最后得到最新数据stale-while-revalidate的用法和max-age相同:。
$ S% k6 m: I: e Cache-Control: max-age=1, stale-while-revalidate=59如果在接下来的 1 秒内重复请求时间,则先前缓存的值仍将是最新的,并按原样使用,无需任何重新验证 如果请求在 1 到 59 秒后重复,虽然缓存是过期了,但仍可以直接使用这个过期缓存,同时进行异步 revalidate。
: N& ~' ^$ Y0 [! P$ K 在 59秒之后,缓存就是完全过期了,需要进行网络请求Vercel根据stale-while-revalidate的思想,推出了一个SWR用于获取数据的 React Hooks 库它能够使我们的组件立即加载缓存的数据,同时能够异步的刷新订阅的数据,以便提供更新后的界面数据。
, z F+ Z9 i4 k' ~4 ^ 组件就有了不断自动地获得数据更新流的能力 上面我们介绍了浏览器的HTTP缓存和service worker缓存,我们来简单梳理一下浏览器在请求资源时遵循的缓存顺序(优先级从高到低):memory cache(如果有) ) l0 K$ l7 v6 J/ O' w! J
Service worker cacheHTTP 缓存(先强缓存然后协商缓存)服务器或CDN 资源提示和预加载 preload预加载
; b$ w2 U: ~4 Z) G7 a- B 元素的 rel 属性的 preload 值允许在 HTML 的 中声明获取请求,以此来指明资源在后续会被很快的用到,这样浏览器就可以尽早的去加载资源(也提高了资源的优先级)这样就确保了资源更早可用,并且不太可能阻止页面的渲染,从而提高性能。 $ q4 g; N( o2 @) B
preload的适用场景 使用preload的基本使用方式是尽早加载后期发现的资源 虽然浏览器的预加载器可以很早就发现大多数在HTML标记上的资源,但并非所有资源都是在HTML上的一些资源就会隐藏在 CSS 和 JavaScript 中,浏览器无法尽早的发现和下载他们。
, P: o# a- G' ?, V8 J$ o* O, v 因此,在很多情况下,这些资源最终会延迟首次渲染或页面关键部分的加载 字体资源的加载是很适合使用preload来优化的在大多数情况下,字体对于在页面上呈现文本至关重要,并且字体的使用深埋在 CSS 中,即使浏览器的预加载器解析了 CSS,也无法确定是否需要它们。
) R- y6 B: u, p 使用preload后,我们就可以提高字体资源的优先级,这样浏览器就可以尽早的预加载。 * x1 }8 F& M" P3 t
有案例表明,使用preload进行字体加载后,可以将整体页面的加载时间缩短一半 preload的使用注意事项虽然preload的好处很明显,但是如果滥用的话可能会浪费用户的带宽并且如果没有在3s 内用到 preload的资源,在浏览器的console会显示警告。 " I0 I5 k5 @6 ~& w/ g1 `2 B9 A
不要省略as属性省略 as 属性或者使用一个无效值,会使preload请求相当于 XHR 请求,浏览器不知道它正在获取什么,并且以相当低的优先级获取它 preload的兼容性 目前主流浏览器都支持preload。 & d, D1 a4 o) H* S% Z2 q1 b# A( E
如果是不支持的浏览器,也会忽略它而不是报错 prefetch资源提示 prefetch是W3C Resource Hints
5 r; s( K: H* n H7 T. R) k5 @ 标准的其中一个指令prefetch的用法是和preload相同的,但是功能却和preload大不一样它主要是告诉浏览器获取下一次导航可能需要的资源 这主要意味着资源将以极低的优先级获取(因为浏览器知道当前页面中需要的所有内容都比我们猜测下一个页面中可能需要的资源更重要)。 8 y9 G9 J* R& G* q2 }
这意味着预取的资源主要是用于加速下一个导航而不是当前导航在浏览器的兼容性上,prefetch可以支持到IE11同时也要说明的是,prefetch和preload的资源如果可以被缓存(例如,有一个有效的cache-control )那么缓存是被存储在 HTTP 缓存中的,并放入浏览器的内存缓存;如果资源不可缓存,则不会存储在 HTTP 缓存中。 # X% M/ ~$ _7 M, w- ?: l; a
相反,它上升到内存缓存并停留在那里直到它被使用 使用Webpack来对prefetch和preload进行支持 Webpack v4.6.0+ 增加了对预获取和预加载的支持import(/* webpackPrefetch: true */ ./path/to/LoginModal.js);。
( b" Y$ }, D# O* t1 Y 这会生成 并追加到页面头部,指示着浏览器在闲置时间预取 login-modal-chunk.js 文件。 - f& m7 q5 K7 h% b
并且只要父 chunk 完成加载,webpack 就会添加 prefetch hint(预取提示)import(/* webpackPreload: true */ ChartingLibrary);preload chunk 会在父 chunk 加载时,以并行方式开始加载。
" a/ t# u' ]$ o$ Z! F( S( V/ U 而prefetch chunk 会在父 chunk 加载结束后才开始加载 quicklinkquicklink是google chrome labs出品的一个很小(< 1KB minified/gzipped)的npm库,旨在是通过在空闲时段内预取视口内链接来加快后续页面加载。 . i5 j% x# g. O1 M7 Y8 a1 t/ |/ h
它的主要原理是:检测视口内的链接(使用 Intersection Observer)等待浏览器空闲,以便在浏览器空闲时进行页面资源的预取(使用 requestIdleCallback)检查用户是否处于慢速连接(使用 navigator.connection.effectiveType)或启用了数据节省(使用 navigator.connection.saveData)
- B; ^0 l: s3 R' w# M 预加载链接的 URL(使用 或 XHR) 提供对请求优先级的一些控制:默认为低优先级,使用rel=prefetch 或 XHR,对于高优先级的资源,尝试使用 fetch() 或回退到 XHR quicklink提供的一个demo显示使用quicklink可以将页面加载性能提高4秒。
9 Q+ ~6 \, m0 C, i3 h% @ 懒加载技术 上面一小节介绍了几个预加载的技术,接下来我们要说一下懒加载懒加载就是延迟加载,它可以极大的减少无效资源的加载,从而提高页面的性能懒加载的核心适用场景就是在当前视口(viewport)外的资源(或者是非关键渲染路径下的资源)不需要加载。
* F9 b x) d+ H8 _5 {; U 代码层面的懒加载最为常见的是我们使用的第三方库的懒加载(Dynamic Import)或者组件懒加载(React的React.lazy),其本质就是动态 import() 语法下面我们来介绍一下其他资源懒加载的实现方式:。 * b# c. C+ m+ g, j
Intersection Observer Intersection Observers API允许用户知道观察到的元素何时进入或退出浏览器的视口利用这个特性,我们可以做到对非当前视口内的资源不加载在我的开源项目。
6 I6 p( B( c, F0 ^0 H* W 基于 React SSR 实现的仿 MOO 音乐风格的音乐网站 中也实现了使用IntersectionObserver API**的图片懒加载,具体代码传送门 在众多第三方前端懒加载实现库中,有一个高性能轻量级的js库。
2 j8 X5 ~. ^$ G1 O) l7 i/ h; C/ o. K9 v Lozad.js,它可以支持 img、picture、iframe、视频、音频、响应式图片、背景图片和多背景图片等多种资源的懒加载不同于现有的延迟加载库与浏览器滚动事件挂钩或者周期性的需要在延迟加载的元素上调用 getBoundingClientRect(),Lozad.js使用的是不阻塞js主线程的Intersection Observers API ,而每次调用 getBoundingClientRect() 都会迫使浏览器重新布局整个页面,可能会给浏览器带来卡顿。 / E! p$ m# ~7 D% n5 E
浏览器原生的图片延迟加  上面的代码可以实现浏览器原生的图片懒加载(基于Chromium 的浏览器和 Firefox,不支持loading属性的浏览器会忽略它的存在)。 W" [8 ?' q4 k! [- ^8 R& U- @( A0 j: N
这样我们就不用使用其他js库来实现图片的懒加载 loading属性有三种取值:auto:使用浏览器的默认加载行为,与不使用loading属性相同lazy:推迟加载资源,直到它达到与视口距离的阈值eager:立即加载资源,无论它位于页面上的什么位置。
' G8 d* @$ j& Z" Q* G3 v* U- _; W 如何理解loading=lazy时的与视口距离的阀值?Chromium 的延迟加载实现试图确保屏幕外图像足够早地加载,以便在用户滚动到它们附近时它们已经完成加载 通过在它们在视口中可见之前获取图片资源,最大限度地提高了它们在变得可见时已经加载的机会。
& b3 j' X) U. h8 r& v 那么如何尽早的加载图片?也就是说不可见的图片在和当前视口的距离为多少时浏览器才会去加载后面的图片呢?答案是Chromium的这个距离阈值不是固定的,取决于以下几个因素:图片资源的类型data-savings是否被开启。 9 w, V/ n& G. j& I! B6 s
当前网络的状况(effective connection type) 根据上面三个因素,Chromium在不断改进这个距离阀值的算法,在节省图片下载的同时,也能保证在用户滚动到图片时图片已加载 页面渲染优化。 - `' C* y: W5 A: R
上面一章节我们从网络的连接和资源的加载两个角度总结了网络资源的优化接下来我们会在拿到页面资源后,对页面的渲染进行分析和优化总结 渲染流程简析 首先我们知道当网络进程接收到请求的响应头之后,如果检查到响应头中的 content-type 字段是text/html,那么会判断这是一个 HTML 类型的文件,也就会为该请求准备一个渲染进程,后续的页面渲染流水线也就在这个渲染进程中展开。 ! e* \8 E2 x7 K( H* U
我们可以把HTML代码看作浏览器页面UI构建初始DOM的蓝图每当解析到脚本元素时,浏览器就会停止从HTML构建DOM,并开始执行Javascrip代码;接收到 CSS 文本时,会将 CSS 文本转换为浏览器可以理解的styleSheets。
. w. o i( q# ?4 X- g* P 所以,渲染器进程的核心工作是将 HTML、CSS 和 JavaScript 转换为用户可以与之交互的网页 HTML的解析 当渲染器进程收到导航的提交消息并开始接收 HTML 数据时,主线程开始解析文本字符串 (HTML) 并将其转换为文档对象模型 (DOM)。 ' o9 X- l, |/ n% d5 \8 [: Q# t* b, R
大概的解析流程是:当渲染器进程收到从网络进程中过来的字节流时,HTML解析器就会将字节流转换为多个Token( Tag Token 和文本 Token),Tag Token 又分 StartTag 和 EndTag,比如就是 StartTag ,就是EndTag 。 3 {. ?( v" w$ X1 K; {
然后通过维护一个Token 栈结构,不断的将新产生的 Token 压栈和出栈,把Token解析为 DOM 节点,并将 DOM 节点添加到 DOM 树中  / n" ]% |. J& Z; |6 o 如果 HTML 文档中存在 或 之类的内容,则预加载扫描器会查看 HTML 解析器生成的Token,并将请求发送到网络进程 script的解析 当 HTML 解析器遇到script标签时,解析器会暂停 HTML 文档的解析,并必须加载、解析和执行 JavaScript 代码。
% {/ r. b; I' G. a0 h" [" c8 B: m 为什么? 因为 JavaScript 可以使用 document.write() 之类的东西来改变文档的形状,这会改变整个 DOM 结构 这就是 HTML 解析器必须等待 JavaScript 运行才能继续解析 HTML 文档的原因。 ' w9 e/ j: M( K4 J/ U; T, [! m$ b+ F
css的解析 拥有 DOM 并不足以知道页面会是什么样子,因为我们可以在 CSS 中设置页面元素的样式与HTML文件一样,浏览器无法直接理解纯文本的CSS样式,因此当渲染引擎接收到CSS文本时,它将执行转换操作,将CSS文本转换为浏览器可以理解的styleSheets,我们可以用document.styleSheets获取。
# @! G' B( A: Q document.styleSheets 现在浏览器可以理解CSS样式表的结构了,再经过CSS属性值的标准化操作和加上CSS 的继承规则和层叠规则,我们就可以计算出 DOM 树中每个节点的具体样式。 / h% p5 J6 S. ^) f
主线程解析CSS,给DOM节点添加计算样式 布局 现在渲染器进程知道文档的结构和每个节点的样式,但这还不足以渲染页面,后续还要经过一个布局阶段布局是一个寻找元素几何形状的过程 主线程遍历 DOM 和计算样式,并创建布局树,其中包含 xy 坐标和边界框大小等信息。 ' d' G0 p6 H4 T0 \# c8 ^! I7 m
布局树可能与 DOM 树的结构相似,但它只包含与页面上可见元素相关的信息 如果有节点被应用了display: none ,那么该元素就不是布局树的一部分了 类似地,如果应用了内容类似于p::before{content:"Hi!"} 的伪类,即使它不在 DOM 中,它也会包含在布局树中。 n6 q3 _6 y7 T) \' D+ f, O* g1 I9 Z
主线程使用计算样式遍历 DOM 树并生成布局树 绘制(Paint) 拥有 DOM、样式和布局树仍然不足以渲染页面,我们还需要知道绘制这些节点的顺序比如,我们可能会为某些元素设置 z-index,在这种情况下,按照 HTML 中编写的元素顺序绘制将导致渲染不正确。 1 t+ z9 d/ F& |8 A) c
在此绘制步骤中,主线程会遍历布局树以创建绘制记录 绘画记录是对“先背景,后文字,再矩形”这样的绘画过程的记录 1 y# y; C. C( s3 B( W0 V
主线程遍历布局树并生成绘制记录 渲染流水线中最重要的一点是,在每一步都使用前一操作的结果来创建新数据 例如,如果布局树中的某些内容发生了变化,则需要为文档的受影响部分重新生成绘制顺序这就牵扯到了重绘和重排的概念,我们后续会说到。 8 `5 M7 A( n! ~7 h1 ^
合成 既然浏览器知道了文档的结构、每个元素的样式、页面的几何形状和绘制顺序,它如何绘制(draw)页面?处理这个问题最简单的方法是在视口内对部分进行光栅化(光栅化可以理解为把布局信息转换为屏幕上的像素)。 0 x' N( z' d* g/ J( {" w
如果用户滚动页面,则移动光栅框架,并通过更多光栅(像素)填充缺失的部分 这就是 Chrome 在首次发布时处理光栅化的方式 然而,现代浏览器运行了一个更复杂的过程,称为合成 合成是一种将页面的各个部分分成多个图层,然后单独光栅化它们,并在一个叫做合成线程的单独线程中合成为一个页面的技术。 6 @7 w! d4 k# a7 T- ]8 i
如果发生滚动,因为图层已经被光栅化,它所要做的就是合成一个新的帧 分层 为了找出哪些元素需要在哪些层,主线程需要遍历布局树创建层树(LayerTree)CSS 的transform动画、页面滚动,或者使用了 z-index 的页面节点都会生成专用的图层。
- c5 G2 i5 u/ B 主线程遍历布局树生成层树 栅格化操作 一旦创建了层树并确定了绘制顺序,主线程就会将该信息提交给合成线程 合成线程然后光栅化每一层 一个图层可能像页面的整个长度一样大,因此合成线程将它们分成多个图块并将每个图块发送到光栅线程。 4 k+ F3 j* [$ {* ]* y) X2 `
光栅线程光栅化每个图块并将它们存储在 GPU 内存中 4 X+ v6 w) x& l8 W4 i1 A
光栅线程创建出图块的位图并发送到GPU 合成线程可以对不同的光栅线程进行优先级排序,以便可以首先对视口内(或附近)的事物进行光栅化 合成显示 一旦所有图块都被光栅化,合成线程将会收集图块的信息(图块在内存中的位置信息和在页面绘制的位置信息),以此来生成一个合成帧(也就是页面的一个帧,该帧包含了所有图块的信息)。 : z) M1 S$ B4 P6 v) l# i: T/ g# ]
这个合成帧就会通过IPC(进程间通信)被提交到浏览器进程,随后多个合成帧就会被送到GPU,以此来展示到屏幕上。如果有一个屏幕滚动事件,那么合成线程就会创建下一个合成帧,然后发送给GPU。 - z5 b" z" R( n" |: P
合成线程创建合成帧帧被发送到浏览器进程然后到 GPU 自此我们从HTML,JS和CSS解析到页面帧的合成了解了一个页面的渲染流水线那我们如何从这个过程中得到页面渲染的性能优化呢? 从渲染流水线得出的优化方法。 / t1 _7 z1 I( [$ ~! ]
我们可以从上面的渲染流水线中得到一下几个关键点:渲染流水线中每一步都使用了前一操作的结果来创建新数据 例如,如果布局树中的某些内容发生了变化,则需要为文档的受影响部分重新生成绘制顺序布局是一个寻找元素几何形状的过程。 0 m- q3 t4 @# W3 |! q
主线程会遍历 DOM 和计算样式,并创建布局树页面帧的合成是在不涉及主线程的情况下完成的合成线程不需要等待样式计算或 JavaScript 执行单个图层上有变动,渲染引擎会通过合成线程直接去处理变换,这些变换并不会涉及到主线程。 . g# H J9 J$ R* [% w* D5 _7 F1 a
带着这几个关键点我们来看一下重排、重绘问题和CSS动画比 JavaScript 动画高效的原因:重排:更新了元素的几何属性(高度等)也就是说重排需要从布局阶段开始更新渲染流水线重绘:更新元素的绘制属性(字体颜色等),会直接进入了绘制阶段,省去了布局和分层阶段。 $ S% a( h% F+ h0 G
CSS动画高效的原因:如果我们用JS来做元素的动画,浏览器必须在每一帧之间运行这些操作 我们的大多数显示器每秒刷新屏幕 60 次 (60 fps); 只有当每一帧在屏幕上移动物体时,动画对人眼来说才会显得平滑。
. \" L% \$ m4 e! c$ A 如果我们的动画是用JS频繁的改变元素的几何属性,那么无疑我们会频繁的触发重排即使我们的动画渲染操作跟上了屏幕刷新,JS的计算也在主线程上运行,它也可能会阻塞我们的页面但是,如果我们使用CSS 的 transform 来实现动画效果,那么浏览器会单独给这个动画元素分为一个图层,那后续的变换效果是直接在合成线程上操作后,提交给了GPU。
0 B4 D7 {0 R7 H0 M# c. R 相比于JavaScript 动画需要JavaScript的执行和样式计算,CSS动画无疑是很高效的同时,再说一个CSS的will-change属性,will-change为web开发者提供了一种告知浏览器该元素会有哪些变化的方法。
4 N; P# N/ ^# x2 f8 r S 用了它之后,浏览器就会给相关元素单独成为一个图层,等这些变换发生时,渲染引擎会通过合成线程直接去处理变换,从而提升了渲染效果但是我们不能滥用这个属性,其中有一点就是图层信息是存在内存中的,过多的图层可能导致页面响应缓慢或者消耗非常多的资源。 ' |$ J& Y- S2 A5 t+ s( d5 b
流式渲染 渲染流水线的源头就是渲染进程收到从网络进程中过来的响应为text/html的字节流响应其实渲染进程和网络进程之间会建立一个共享数据的管道,网络进程接收到数据后就往这个管道里面放,而渲染进程则从管道的另外一端不断地读取数据,将其解析为 DOM。 0 `% H v+ }" Z
也就是说浏览器解析DOM时,不是等拿到整个HTML才开始渲染的,这也是浏览器的渐进式 HTML 渲染功能 为了充分利用浏览器的这个能力,我们使用服务端渲染(SSR)的同时,可以采用服务端的流式渲染流式服务端渲染允许我们以块的形式发送 HTML,浏览器可以在接收到时就可以逐步呈现HTML。
; b! {6 L0 j' J+ |& i/ ] 这可以极大的提高FP(First Paint)和FCP (First Contentful Paint)指标 在 React 的SSR中,我们用renderToNodeStream来实现异步的流,这样我们也可以大大的提高页面首字节响应。 7 o# u9 M0 @6 B/ |* c
在我的开源项目基于 React SSR 实现的仿 MOO 音乐风格的音乐网站 中也实现了React的renderToNodeStream创建的流pipe给了response对象 ,具体代码传送门除了服务端的流式渲染,我们还可以使用Service Worker来实现流式响应。 , K ]/ }( L& w0 s
self.addEventListener(fetch, event => {
2 B! R2 o" b+ ?6 g9 l* W" Q; U var stream = new ReadableStream({
1 V0 e/ w+ x' p4 U' {1 [ start(controller) {
# y2 e5 v7 l9 \6 Q' \ X if (/* theres more data */) {9 x$ H/ K k* s2 T& x
controller.enqueue(/* your data here */);
5 S/ K: A6 s. R+ H } else {0 K2 z4 a" c0 V# g
controller.close();8 h% w9 T! l% m& z- d8 T% Q7 }
}
# s [; F+ f7 ~/ b8 H- L* M });: p: C' |) s D
});
' [ t# v/ Z1 V; c, _, x8 Y# T
var response = new Response(stream, {
; v7 P# w, [1 Q5 s& f' ] headers: {content-type: /* your content-type here */}! ]/ t; f8 s# `" b& `8 s
});, C! s' e: ^7 E% w5 @
1 S+ T& u. ^5 d; Y* g0 v1 @
event.respondWith(response);7 h$ j7 G; V# V |- y) Y1 N8 n4 ]
});
7 }. J1 ?) ?& m9 j c4 m5 M6 L 一旦 event.respondWith() 被调用,其请求触发了 fetch 事件的页面就会得到一个流响应,并且只要 Service Worker继续 enqueue() 附加数据,它就会继续从该流中读取。 0 T$ }3 u" R4 R0 e! U8 J
从 Service Worker 流向页面的响应是真正异步的,我们可以完全控制填充流这里有一个完整的demo也就是如果我们把服务端流式响应的动态数据再加上通过Service Worker实现的流式响应的缓存数据,就真正做到了流式的快速响应。
$ R% K; s- r' k; e7 u" H! T 文章参考:Web VitalsAssessing Loading Performance in Real Life with Navigation and Resource TimingNavigation Timing Level 2
, A5 h0 c' i6 e% j$ b Custom metrics《浏览器工作原理与实践》- 李兵Browser-level image lazy-loading for the webMake use of long-term caching / U0 u# [( z; E) F0 v5 o" r
Service worker caching and HTTP cachingPreload, Prefetch And Priorities in ChromeInside look at modern web browser (part 3)
0 y) v, c4 w F4 O Stream Your Way to Immediate ResponsesRendering on the Web 3 J8 ^' b+ K K
7 ?7 B% u5 z3 }3 v" r
7 a) T" T2 a3 f7 G" Z0 m: B
3 ~! C! ?4 l7 J* i# Y% A! V2 S: `( @$ f) h4 ^7 n
|