|
$ B5 \6 r9 M% U5 _2 P! z 长尾词挖掘思路来源:君言:如何在百万级的数据里找到别人正在赚钱的项目5290 赞同 · 236 评论文章  2 S( E! Y( Y! a3 p+ S) m 作为一名菜鸟算法工程师对里面的数据分析思路很感兴趣,趁着周末就实操了一遍期望也能挖掘点赚钱的项目,主要代码如下:importnumpyasnpfromnumpy.randomimportpermutation 7 X1 Y) {- m4 k5 D
importpandasaspdimportsklearnassklearnimportmatplotlib.pyplotaspltfromsklearn.feature_extraction.text 8 \: \+ v, n) H+ K
importCountVectorizerfromsklearn.feature_extraction.textimportTfidfVectorizerimportjiebafromdatetimeimport
3 N- E! A( `7 M0 G datetime,date,timedeltaimportpickleimportsysimportosimportwarningswarnings.filterwarnings(ignore)%matplotlib , c: _) |* l6 t
inlinepd.set_option(display.max_columns,None)pd.set_option(display.float_format,lambdax:%.6f%x)plt.rcParams
- [ l. q, @. X$ w! E# t5 h# K [font.sans-serif]=[SimHei]plt.rcParams[axes.unicode_minus]=False导入停用词停用词库来源:(https://github.com/goto456/stop # a' P. H' g y; P
words)stop_words_df=pd.read_csv(baidu_stopwords.csv)stop_words_df.head()导入从5118下载的怎么长尾词(需要开通VIP才能下载)长尾关键词挖掘_关键词挖掘工具_关键词查询 - 5118营销大数据 5 x0 z( I0 B4 @1 N8 m8 C# k4 |
ci.5118.com/?promote=pp2020how_df=pd.read_csv(怎么长尾词_1602384585.csv,encoding="gbk")how_df.info()
! C! w4 ?& D' c! q7 t8 Y pandas.core.frame.DataFrame>RangeIndex:500000entries,0to499999Datacolumns(total12columns):关键词500000non # i/ Q8 {4 L" ~5 s" Z0 ^8 A
-nullobject长尾词数量500000non-nullint64搜索结果500000non-nullobjectSEM点击价格(SVIP特权数据)0non-nullfloat64流量特点(SVIP特权数据
1 s" n* L' R5 G6 ]4 H/ Z )0non-nullfloat64流量指数(VIP特权数据)500000non-nullint64移动指数(VIP特权数据)500000non-nullobject360指数(VIP特权数据)500000 " f, U1 L1 T# }) q8 z4 l
non-nullobject竞价公司数量(VIP特权数据)500000non-nullobjectPC日检索量(VIP特权数据)500000non-nullobject移动日检索量(VIP特权数据)500000 - f' V- W. M% } w) v
non-nullobject竞价竞争激烈程度(VIP特权数据)500000non-nullobjectdtypes:float64(2),int64(2),object(8)memoryusage:45.8 Y. Q s/ `8 F9 j' b+ S. k" G( ?
+MBhow_df.head() 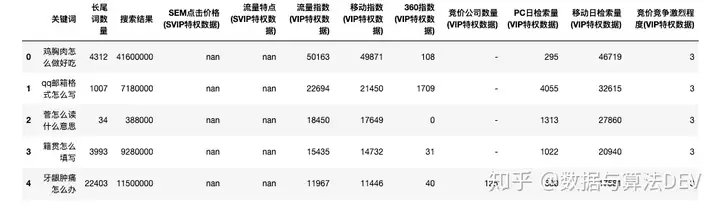 / a4 q# f- M! Y3 o7 A( }' z- ? 5118导出的长尾词去除长度少于5和超过20的关键词words_df=how_df[(how_df[关键词].str.len()>5)&(how_df[关键词].str.len()<20)][[关键词]]
, G8 Y9 U; d6 X- c0 M8 J* u, |% A words_df.head()  4 J( H, f8 B: F$ @ 长尾词示例words_df[wlen]=words_df[关键词].str.len()words_df.columns=[words,wlen]words_df.head() 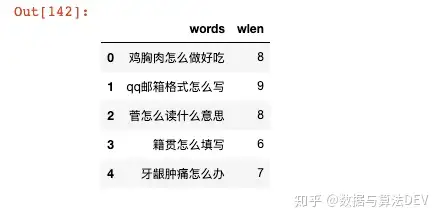 " _" c& [' L* q S4 u: H6 F 使用jieba分词统计词频jieba官网:(https://github.com/fxsjy/jieba)importpdbdefcalc_word_freq(words,words_freq_dict + J! D. j6 J7 l3 a
,stop_words_set): 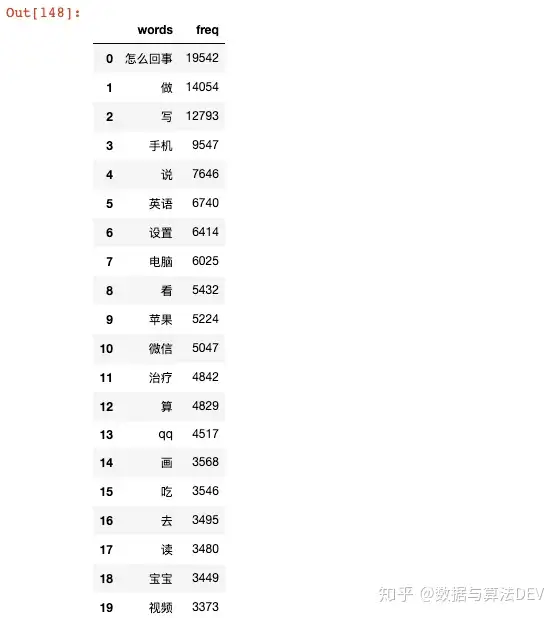 G5 e7 X9 P" j0 s" G 训练模型用于统计词频和进行相似度计算words_df.head() 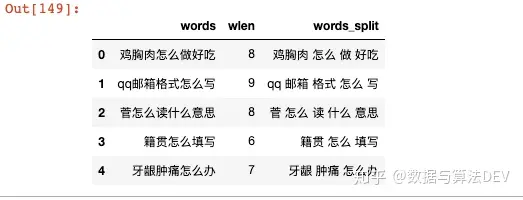 9 ]2 a) o; h- R" B! r 分词示例# 训练模型长尾词分类fromsklearn.clusterimportKMeansimporttimeit# 假设分为100个类别# 无监督方法分类执行速度Mac 8G内存,50w个词7分钟跑完,看上去速度还行
3 H# y7 P: ~! Z) m, s 预测长尾词类别words_df[words_class]=kmeans.predict(cv_vec)输出每个分类的长尾词库foriinrange(1,101):words_df[words_df.words_class 8 X: B Y2 s3 Z% P; J. I
==i][[words]].sort_values(by=words).to_csv(class_+str(i)+.csv,index=None,columns=[words])class_1=pd.read_csv }+ k- F7 F% y! G3 C
(class_36.csv)class_1.head(10) 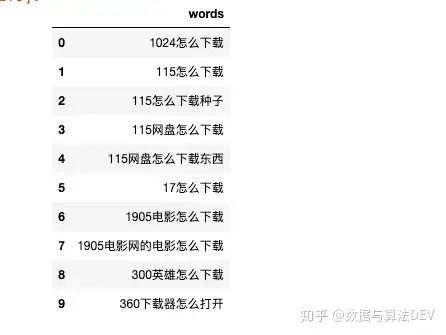 6 d" v1 T% j) [$ _9 i 长尾词分类示例看上去分类结果还可以。 + T. n% A+ M" A* U$ t; ?- }4 P
: N0 ~, S% `) |
+ e; C2 f# o7 Z! E% C7 i( } _4 R
: T5 g: G( S E" t2 w7 P
& ], Z8 r! Z9 p x+ S8 ~2 @$ g& } | 


