|
& s# o1 v6 a! m 原标题:R语言SVM支持向量机、文本挖掘新闻语料情感情绪分类和词云可视化全文链接:http://tecdat.cn/?p=32032原文出处:拓端数据部落公众号支持向量机(SVM)是一种机器学习方法,基于结构风险最小化原则,即通过少量样本数据,得到尽可能多的样本数据。 $ z4 P! T" k0 k, W1 U; b
支持向量机对线性问题进行处理,能解决非线性分类问题本文介绍了R语言中的 SVM工具箱及其支持向量机(SVM)方法,并将其应用于文本情感分析领域,结果表明,该方法是有效的在此基础上,对文本挖掘新闻语料进行情感分类和词云可视化,从视觉上对文本进行情感分析。 $ d8 X/ s, p/ c
语料是从yahoo Qimo上爬的新闻语料,一共49000篇,每篇包含题目、新闻内容、评论、读者投票结果(投票选择依次为:实用,感人、开心、超扯、无聊、害怕、难过、火大)以及总投票个数。数据概览 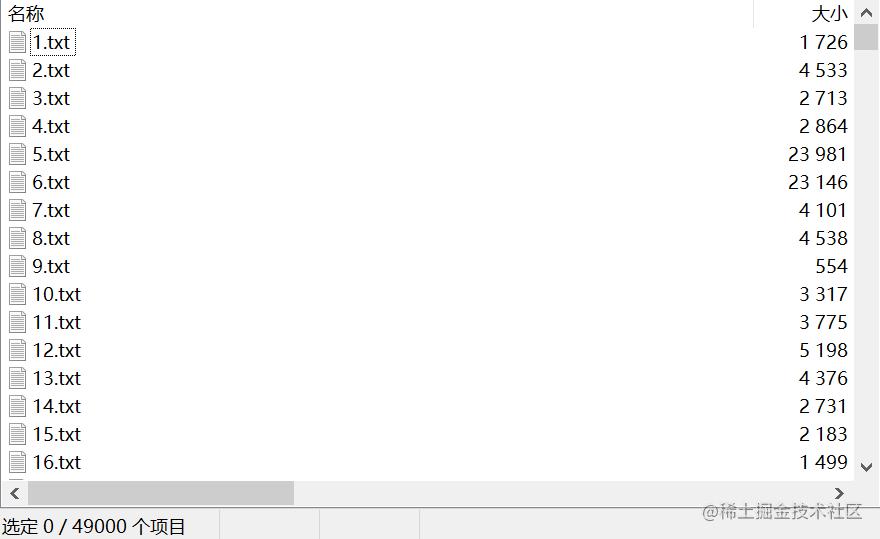 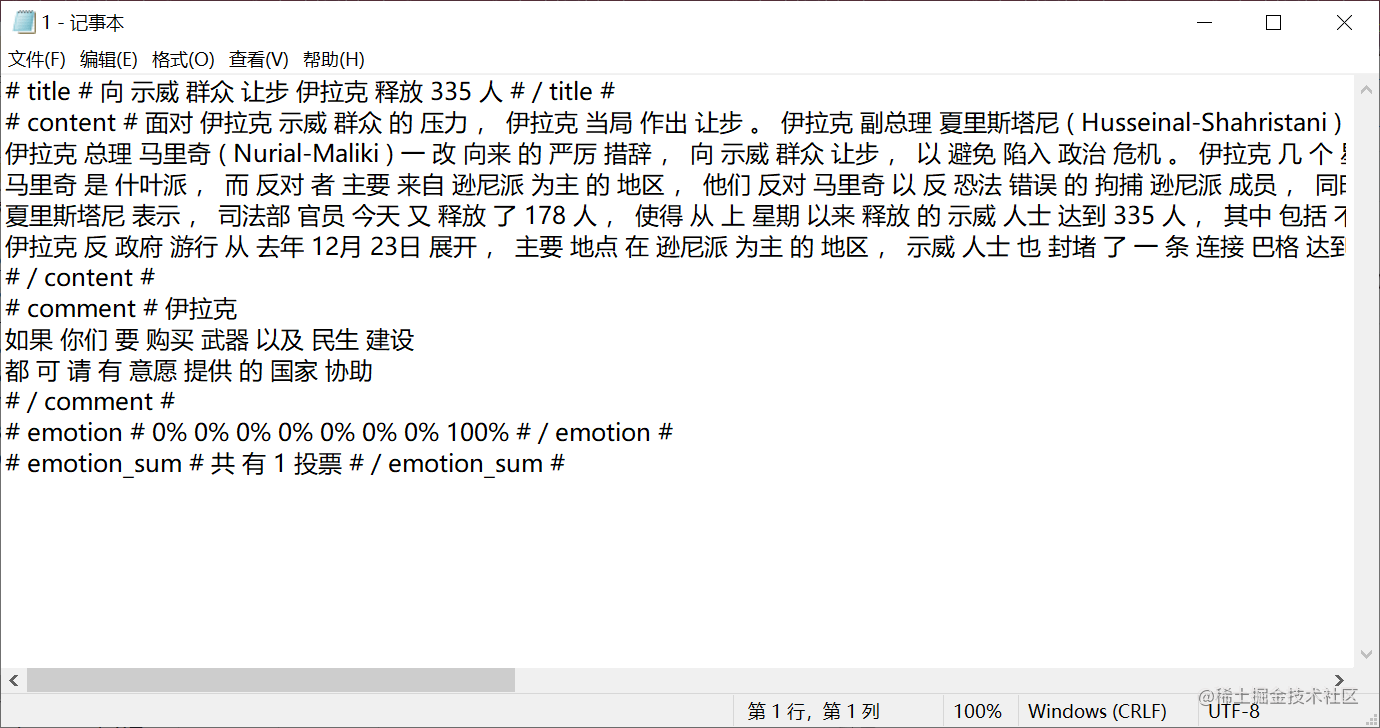 % _( {4 B' S* `# M 以第一个预料为例对其分词提取关键词library(jiebaR)cutter = worker(type = "keywords", topn = 10) words = "1.txt" 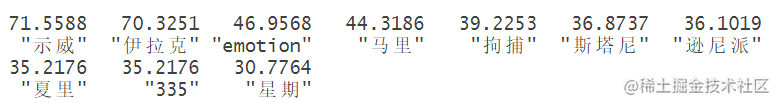 2 Z* k# M. r1 }' j/ n! X U( _ 查看工作目录下所有的文件dir = list.files(".")获取分类号xx<-readLines(dir[i],encoding = "UTF-8")## Warning in readLines(dir[i], encoding = "UTF-8"): 读1.txt时最后一行未遂 & c+ H0 u) b% _9 F9 a
# xx<-readLines("2.txt",encoding = "UTF-8") class=strsplit(xx[length(xx)-1],split="#")[[1]][3]词性分类for(i in 1:10){ 3 E6 `& G; j! }( k7 v C
cutter = worker(type = "keywords", topn = 10)绘制词汇图mycolors <- brewer.pal(8,"Dark2")#设置一个颜色系:wordcloud(cutter_words, y* ^9 ~4 }$ p, `6 s3 |9 j: Q
as.numeriter_words)),random.order=FAL 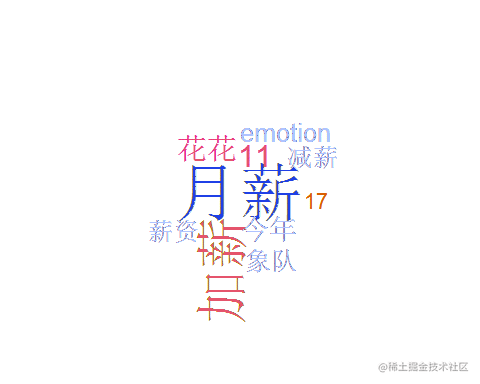 5 u6 N6 C+ n6 q: Y. C 准备训练集和测试集ntrain <- round(n*0.8) # 训练集 tindex <- sample(n,ntrain) # 筛选测试集样本 xtrain<-textdata[tindex,]
% H0 P& r1 V& ~$ j5 n" W0 ~& U xtest<-textdata[-tindex,]#可视化 plot(textdata[,c("classlist","X1")] ,pch=ifelse(istrain==1,1,2)) 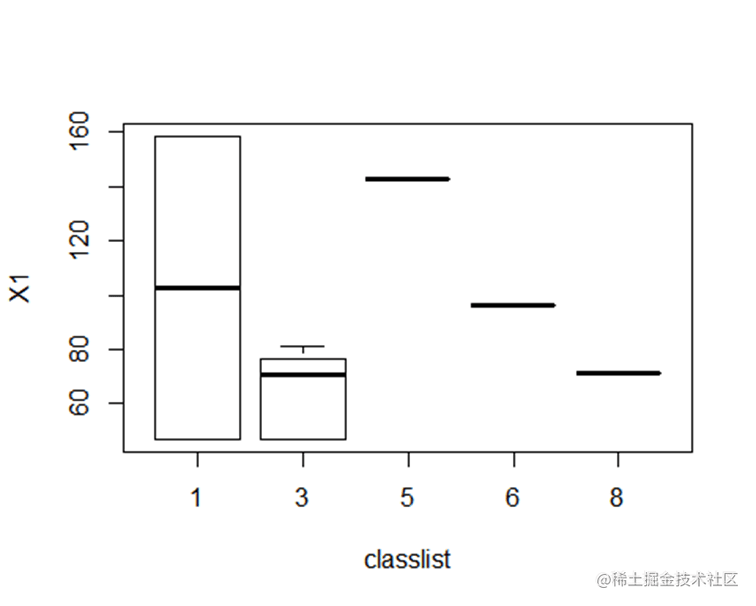 2 ~4 U& A' {6 ^3 L: m% e 训练SVM现在我们在训练集上使用来训练线性SVMsvm(classlist ~ . , textdata) 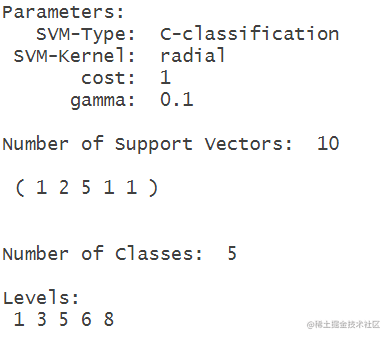 $ {3 l1 ]" u! Q) O4 \/ O 预测数据predictedY <- predict(model, textdata)预测的数据  7 ?7 F9 e: E# d6 U 查看分类混淆矩阵 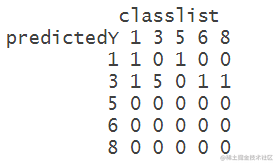  0 ?) k+ e4 _9 A2 z) a0 |% O 最受欢迎的见解1.Python主题建模LDA模型、t-SNE 降维聚类、词云可视化文本挖掘新闻组2.R语言文本挖掘、情感分析和可视化哈利波特小说文本数据3.r语言文本挖掘tf-idf主题建模,情感分析n-gram建模研究 8 W' L8 a/ D- n; h' O# }
4.游记数据感知旅游目的地形象5.疫情下的新闻数据观察6.python主题lda建模和t-sne可视化7.r语言中对文本数据进行主题模型topic-modeling分析8.主题模型:数据聆听人民网留言板的那些“网事” / w7 ^6 t# Q$ d( I. T
9.python爬虫进行web抓取lda主题语义数据分析返回搜狐,查看更多责任编辑:
3 x B3 C0 c. l0 u: E6 V3 }: G3 y3 O
7 F) t/ v3 k* x# v+ V& g; U" f4 W! p$ Z" l) Q/ Y* V
9 c( }) b( {( W% h' c
- o1 T) u4 P2 m& F
| 



 2 Z* k# M. r1 }' j/ n! X U( _
 5 u6 N6 C+ n6 q: Y. C

 0 ?) k+ e4 _9 A2 z) a0 |% O


