|
/ ~7 A) g5 [! y1 j. f8 T/ G 原标题:千亿参数开源大模型 BLOOM 背后的技术❝假设你现在有了数据,也搞到了预算,一切就绪,准备开始训练一个大模型,一显身手了,“一朝看尽长安花”似乎近在眼前 …… 且慢!训练可不仅仅像这两个字的发音那么简单,看看 BLOOM 的训练或许对你有帮助。
I0 H* Z) k! j% B2 t! q 近年来,语言模型越训越大已成为常态大家通常会诟病这些大模型本身的信息未被公开以供研究,但很少关注大模型训练技术这种背后的知识本文旨在以 1760 亿参数的语言模型 BLOOM 为例,阐明训练此类模型背后的软硬件工程和技术要点,以促进大家对大模型训练技术的讨论。 ! k* n4 l9 B" B5 V, x& e
BLOOM 文档链接: https://hf.co/bigscience/bloom 首先,我们要感谢促成或赞助我们这个小组最终完成了训练 1760 亿参数模型这一惊人壮举的公司、个人和团体然后,我们开始讨论硬件配置和主要技术组件。  ( |1 d5 g0 V% @$ e1 U3 L BLOOM 以下是对本项目的简要总结:硬件384 张 80GB A100 GPU软件Megatron-DeepSpeed模型架构基于 GPT3数据集含 59 种语言,共 3500 亿词元训练时长3.5 个月
8 X' Q B$ n" j" I7 {5 d 人员组成该项目由 Thomas Wolf (Hugging Face 联合创始人兼 CSO) 发想,他敢于与大公司竞争,提出不仅要训练出立于世界上最大的多语言模型之林的模型,还要让所有人都可以公开访问训练结果,圆了大多数人的梦想。 ! ?* H: r# i( @
本文主要关注模型训练的工程方面BLOOM 背后的技术中最重要的部分是分享专业知识并帮助我们进行编码和训练的人员和公司我们主要需要感谢 6 个群体:HuggingFace 的 BigScience 团队投入了六名以上的全职员工全程参与了训练的研究和运行,他们还提供或报销了 Jean Zay 计算机之外的所有基础设施。
8 i) E G% F$ ~: y Microsoft DeepSpeed 团队,开发了 DeepSpeed,后来将其与 Megatron-LM 集成,其开发人员花费数周时间研究项目需求,并在训练前和训练期间提供了许多很棒的实用经验建议。
+ O; z3 c* R; R+ J# w1 l" I. u NVIDIA Megatron-LM 团队开发了 Megatron-LM,他们非常乐于回答我们的大量问题并提供一流的使用建议 IDRIS / GENCI 团队管理着 Jean Zay 超级计算机,他们为该项目捐赠了大量的算力和强大的系统管理支持。 # t8 J3 b* A9 H" ]
PyTorch 团队创建了一个超强的框架,其余软件都基于该框架,并且在准备训练期间非常支持我们,修复了多个 bug 并提高了我们所依赖的 PyTorch 组件的训练可用性 BigScience 工程工作组志愿者 很难说出所有为该项目的工程方面做出贡献的杰出人物的名字,所以我只列举 Hugging Face 之外的几个关键人物,他们在过去 14 个月中为该项目奠定了工程基础: Olatunji Ruwase、Deepak Narayanan、Jeff Rasley、Jared Casper、Samyam Rajbhandari 和 Rémi Lacroix。 : t+ D& ~: ]3 l2 p. L1 }
我们也感谢所有允许其员工为该项目做出贡献的公司概述BLOOM 的模型架构与 GPT3 非常相似,只是增加了一些改进,本文稍后将对此进行讨论该模型是在 Jean Zay 上训练的,Jean Zay 是由 GENCI 管理的法国GOV资助的超级计算机,安装在法国国家科学研究中心 (CNRS) 的国家计算中心 IDRIS。 - j/ O8 e4 z, `" \- D4 x/ a0 i' d s
训练所需的算力由 GENCI 慷慨捐赠给本项目 (捐赠号 2021-A0101012475)训练硬件:GPU: 384 张 NVIDIA A100 80GB GPU (48 个节点) + 32 张备用 GPU % x$ R; R6 G& \7 F
每个节点 8 张 GPU,4 条 NVLink 卡间互联,4 条 OmniPath 链路 CPU: AMD EPYC 7543 32 核处理器 CPU 内存: 每个节点 512GB GPU 显存: 每个节点 640GB
) u Z: T: L; \; Z/ v$ t 节点间连接: 使用 Omni-Path Architecture (OPA) 网卡,网络拓扑为无阻塞胖树 NCCL - 通信网络: 一个完全专用的子网 磁盘 IO 网络: GPFS 与其他节点和用户共享
3 }# W# ^1 B( J9 U Checkpoints:主 checkpoints https://hf.co/bigscience/bloom 每个 checkpoint 含精度为 fp32 的优化器状态和精度为 bf16+fp32 的权重,占用存储空间为 2.3TB。
. Y% P. v) I2 b; k* m+ P" n( Z; s3 z 如只保存 bf16 的权重,则仅占用 329GB 的存储空间 数据集:1.5TB 经过大量去重和清洗的文本,包含 46 种语言,最终转换为 350B 个词元 模型的词汇表含 250,680 个词元 更详细信息,请参阅 The BigScience Corpus A 1.6TB Composite Multilingual Dataset # O: Q# R4 m8 P" l# S# a4 i
https://openreview.net/forum?id=UoEw6KigkUn 176B BLOOM 模型的训练于 2022 年 3 月至 7 月期间,耗时约 3.5 个月完成 (约 100 万计算时)。 1 Q& n$ ~! `. E! r g( V- {! S
Megatron-DeepSpeed176B BLOOM 模型使用 Megatron-DeepSpeed 进行训练,它结合了两种主要技术:Megatron-DeepSpeed: https://github.com/bigscience-workshop/Megatron-DeepSpeed % H3 z( O; g: d) R: P U
DeepSpeed 是一个深度学习优化库,让分布式训练变得简单、高效且有效 https://github.com/microsoft/DeepSpeed Megatron-LM 是由 NVIDIA 的应用深度学习研究团队开发的大型、强大的 transformer 模型框架。
" M8 o1 U! l/ g6 E3 U& L4 _, H: c1 W https://github.com/NVIDIA/Megatron-LM DeepSpeed 团队通过将 DeepSpeed 库中的 ZeRO 分片和流水线并行 (Pipeline Parallelism) 与 Megatron-LM 中的张量并行 (Tensor Parallelism) 相结合,开发了一种基于 3D 并行的方案。 . V$ F4 W% U& Q
有关每个组件的更多详细信息,请参见下表请注意,BigScience 的 Megatron-DeepSpeed 是基于原始 Megatron-DeepSpeed 代码库,我们还在其上添加了不少代码BigScience 的 Megatron-DeepSpeed: 。 / j1 u7 z& t- e" r: d5 D- O7 o: r
https://github.com/bigscience-workshop/Megatron-DeepSpeed 原版的 Megatron-DeepSpeed: https://github.com/microsoft/Megatron-DeepSpeed
0 D/ p0 U6 o2 n! t" _6 U8 s8 ~" ]' L 下表列出了我们在训练 BLOOM 时各采用了两个框架的哪些组件:组件DeepSpeedMegatron-LMZeRO 数据并行是张量并行是流水线并行是BF16 优化器是CUDA 融合核函数是数据加载器是 / D$ `- t+ x7 [6 p6 z8 }5 O% j
请注意,Megatron-LM 和 DeepSpeed 都有流水线并行和 BF16 优化器实现,但我们使用 DeepSpeed 的实现,因为它们集成进了 ZeROMegatron-DeepSpeed 实现了 3D 并行以允许大模型以非常有效的方式进行训练。
+ Q& |, n( ?; P! `3 x7 I( i, T 我们简要讨论一下有哪些 3D 组件数据并行 (Data Parallelism,DP)- 相同的设置和模型被复制多份,每份每次都被馈送不同的一份数据处理是并行完成的,所有份在每个训练步结束时同步 张量并行 (Tensor Parallelism,TP) . i8 q8 ~/ m! N) x* w/ R
- 每个张量都被分成多个块,因此张量的每个分片都位于其指定的 GPU 上,而不是让整个张量驻留在单个 GPU 上在处理过程中,每个分片在不同的 GPU 上分别并行处理,结果在步骤结束时同步这就是所谓的水平并行,因为是做的水平拆分。
$ l8 H! L7 D, z- `+ p$ u 流水线并行 (Pipeline Parallelism,PP)- 模型在多个 GPU 上垂直 (即按层) 拆分,因此只有一个或多个模型层放置在单个 GPU 上每个 GPU 并行处理流水线的不同阶段,并处理 batch 的一部分数据。
& g. b) M% ~5 {. Z 零冗余优化器 (Zero Redundancy Optimizer,ZeRO)- 也执行与 TP 相类似的张量分片,但整个张量会及时重建以进行前向或反向计算,因此不需要修改模型它还支持各种卸载技术以补偿有限的 GPU 内存。 3 ^- o/ l- Q" V0 y# d
数据并行大多数只有几张 GPU 的用户可能比较熟悉 DistributedDataParallel(DDP),这是相应的 PyTorch 文档在该方法中,模型被完全复制到每个 GPU,然后在每次迭代后所有模型相互同步各自的状态。 . j, r2 l0 G! h/ E! n) `, X: ^' D+ C
这种方法可以通过投入更多 GPU 资源的方式加快训练速度,解决问题但它有个限制,即只有当模型能够放进单个 GPU 时才有效PyTorch 文档: https://pytorch.org/docs/master/generated/torch.nn.parallel.DistributedDataParallel.html
$ R: g! ~, X+ y0 b ZeRO 数据并行下图很好地描述了 ZeRO 数据并行 (来自下列博文)https://www.microsoft.com/en-us/research/blog/zero-deepspeed-new-system-optimizations-enable-training-models-with-over-1000-billion-parameters/ 。 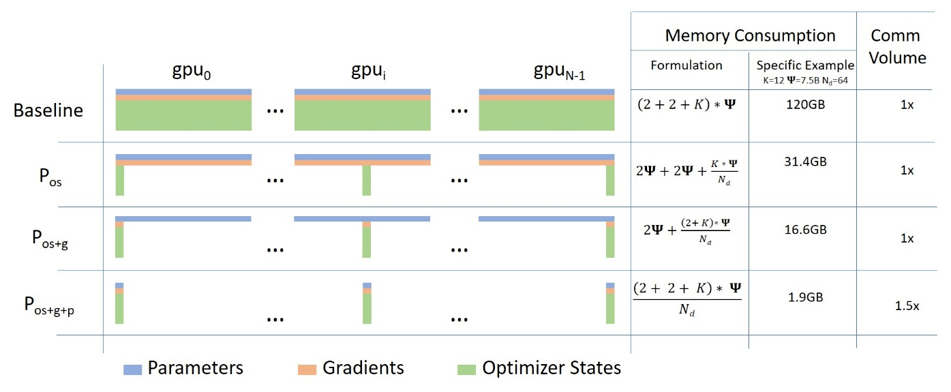 / x/ |0 m' M9 }0 n* I DeepSpeed-Image-1 看上去比较高大上,可能让你很难专心去理解,但实际上,这个概念非常简单这只是通常的 DDP,只是没有每个 GPU 都复制完整的模型参数、梯度和优化器状态,而是每个 GPU 只存储其中的一部分。
/ f6 |# H5 R& I# I 在随后的运行过程中,当需要给定层的完整层参数时,所有 GPU 同步以相互提供它们缺失的部分 —— 仅此而已该组件由 DeepSpeed 实现张量并行在张量并行 (TP) 中,每个 GPU 仅处理张量的一部分,并且仅当某些算子需要完整的张量时才触发聚合操作。 _+ c/ K5 G( h# h7 _! q
在本节中,我们使用 Megatron-LM 论文 Efficient Large-Scale Language Model Training on GPU Clusters 中的概念和图表Efficient Large-Scale Language Model Training on GPU Clusters 论文:。 5 S% ]; N# d2 S
https://arxiv.org/abs/2104.04473 Transformer 类模型的主要模块为: 一个全连接层 nn.Linear,后面跟一个非线性激活层 GeLU沿用 Megatron 论文的符号,我们可以将其点积部分写为 Y = GeLU (XA),其中 X 和 Y 是输入和输出向量, A 是权重矩阵。
1 Q) o; ~$ o- m: F9 F3 @3 ] 如果以矩阵形式表示的话,很容易看出矩阵乘法可以如何在多个 GPU 之间拆分: 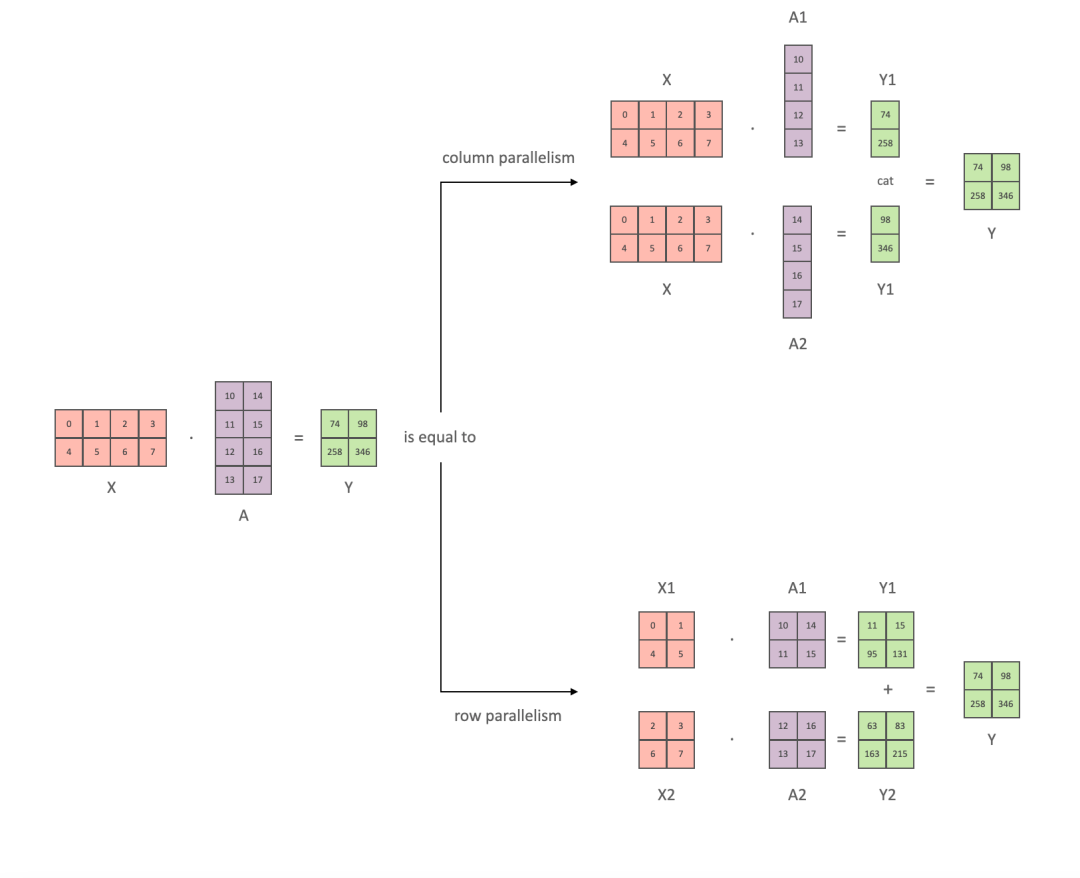 7 C6 l; o* r3 k1 y2 Y2 f 并行 GEMM 如果我们将权重矩阵 A 按列拆分到 N 个 GPU 上,然后并行执行矩阵乘法 XA_1 到 XA_n,那么我们最终将得到 N 个输出向量 Y_1、Y_2、…… 、 Y_n ,它们可以独立输入 GeLU: ! W$ d% l' M7 [, M( i2 H
注意因为 Y 矩阵是按列拆分的,因此随后的 GEMM 我们可以选择按行拆分方案,这样它就可以直接获取前面层的 GeLU 的输出,而无需任何额外的通信使用该原理,我们可以更新任意深度的 MLP,只需在每个 拆列 - 拆行 序列之后同步 GPU。 7 U. { k* \$ Q6 }
Megatron-LM 论文作者为此提供了一个不错的图示: 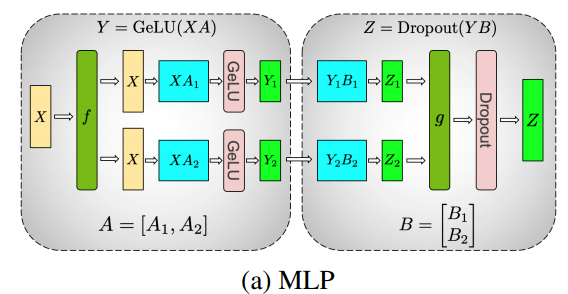 * k: N' ?/ h" p/ F! H 并行分片处理 这里 f 是前向传播中的恒等运算符,后向传播中的 all reduce,而 g 是前向传播中的 all reduce 和后向传播中的恒等式并行化多头注意力层甚至更简单,因为它们本来就是并行的,因为有多个独立的头!。 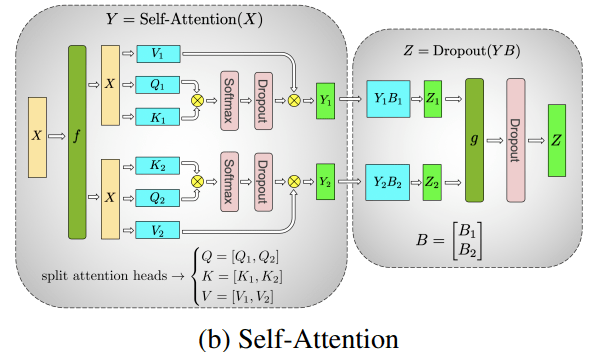 , d1 u" }+ X D0 R 并行自注意力 需要特别考虑的是: 由于前向和后向传播中每层都有两个 all reduce,因此 TP 需要设备间有非常快速的互联因此,除非你有一个非常快的网络,否则不建议跨多个节点进行 TP我们训练 BLOOM 的硬件配置中,节点间的速度比 PCIe 慢很多。 * }) c5 F: a% R( L; U
实际上,如果节点有 4 个 GPU,则最高 TP 度设为 4 比较好如果需要 TP 度为 8,则需要使用至少有 8 个 GPU 的节点该组件由 Megatron-LM 实现Megatron-LM 最近扩展了张量并行能力,新增了序列并行的能力,用于难以使用前述切分算法的算子,如 LayerNorm。 : f! j0 ?3 B7 H6 O5 A( ?
Reducing Activation Recomputation in Large Transformer Models 论文提供了此技术的详细信息序列并行是在训练 BLOOM 之后开发的,所以 BLOOM 训练时并未采用此技术。
* ~7 c6 q) X" S# m4 ~ Reducing Activation Recomputation in Large Transformer Models 论文:https://arxiv.org/abs/2205.05198 流水线并行 # z. R5 }/ ?3 u& p
朴素流水线并行 (naive PP) 是将模型各层分组分布在多个 GPU 上,并简单地将数据从 GPU 移动到 GPU,就好像它是一个大型复合 GPU 一样该机制相对简单 - 将所需层用 .to 方法绑到相应设备,现在只要数据进出这些层,这些层就会将数据切换到与该层相同的设备,其余部分保持不变。
' z# p# Q* N5 f" g3 D/ K0 a 这其实就是垂直模型并行,因为如果你还记得我们是怎么画大多数模型的拓扑图的,我们其实是垂直切分模型各层的例如,如果下图显示一个 8 层模型:=================== =================== 。 6 C( t& H' J u% x; u
| 0 | 1 | 2 | 3 | | 4 | 5 | 6 | 7 | =================== =================== GPU0 GPU1 我们将它垂直切成 2 部分,将层 0-3 放置在 GPU0 上,将层 4-7 放置在 GPU1 上。
+ ^6 U" V- ?2 n+ |4 ^4 {) _# U 现在,当数据从第 0 层传到第 1 层、第 1 层传到第 2 层以及第 2 层传到第 3 层时,这就跟单 GPU 上的普通前向传播一样但是当数据需要从第 3 层传到第 4 层时,它需要从 GPU0 传输到 GPU1,这会引入通信开销。
0 S% U( N+ P; a 如果参与的 GPU 位于同一计算节点 (例如同一台物理机器) 上,则传输非常快,但如果 GPU 位于不同的计算节点 (例如多台机器) 上,通信开销可能会大得多然后第 4 到 5 到 6 到 7 层又像普通模型一样,当第 7 层完成时,我们通常需要将数据发送回标签所在的第 0 层 (或者将标签发送到最后一层)。 ' U( A% }( H* e* n0 k ?! T$ ?
现在可以计算损失,然后使用优化器来进行更新参数了问题:该方法为什么被称为 朴素流水线并行呢,它又有什么缺陷呢?主要是因为该方案在任意给定时刻除了一个 GPU 之外的其他所有 GPU 都是空闲的因此,如果使用 4 个 GPU,则几乎等同于将单个 GPU 的内存量翻两番,而其他资源 (如计算) 相当于没用上。
* c! v# G4 L: C4 \! Z 另外还需要加上在设备之间复制数据的开销所以 4 张 使用朴素流水线并行的 6GB 卡将能够容纳与 1 张 24GB 卡相同大小的模型,而后者训练得更快,因为它没有数据传输开销但是,比如说,如果你有 40GB 卡,但需要跑 45GB 模型,你可以使用 4x 40GB 卡 (也就刚刚够用,因为还有梯度和优化器状态需要显存)。 $ N( W2 j* I$ f2 ^# H7 n3 i6 w% y
共享嵌入可能需要在 GPU 之间来回复制我们使用的流水线并行 (PP) 与上述朴素 PP 几乎相同,但它解决了 GPU 闲置问题,方法是将传入的 batch 分块为 micros batch 并人工创建流水线,从而允许不同的 GPU 同时参与计算过程。
* E6 }. M1 G) y1 z 下图来自于 GPipe 论文,其上半部分表示朴素 PP 方案,下半部分是 PP 方法:GPipe 论文:https://ai.googleblog.com/2019/03/introducing-gpipe-open-source-library.html 2 |7 y2 Z1 N7 _( W; p% h; Z
mp-pp 从图的下半部分很容易看出 PP 的死区 (指 GPU 处于空闲状态) 更少,即 “气泡” 更少图上两种方案的并行度均为 4 ,即由 4 张 GPU 组成流水线于是就有了 F0、F1、F2、F3 这 4 个管级的前向路径,然后是 B3、B2、B1、B0 的逆序后向路径。
+ f( z' _; Y4 a1 k PP 引入了一个新的超参数来调整,称为 块 (chunks)它定义了通过同一管级按顺序发送多少数据块例如,在图的下半部分,你可以看到 chunks = 4GPU0 在 chunk 0、1、2 和 3 (F0,0、F0,1、F0,2、F0,3) 上执行相同的前向路径,然后等待,等其他 GPU 完成工作后,GPU0 会再次开始工作,为块 3、2、1 和 0 (B0,3、B0,2、B0,1、B0,0) 执行后向路径。
+ p# ^* h8 T2 A3 E K 请注意,从概念上讲,这与梯度累积 (gradient accumulation steps,GAS) 的意思相同PyTorch 叫它 块,而 DeepSpeed 叫它 GAS因为 块,PP 引入了 micro-batches (MBS) 的概念。 5 b t1 J) v% l9 p, ]5 U Y* e4 h/ R8 Q: u
DP 将全局 batch size 拆分为小 batch size,因此如果 DP 度为 4,则全局 batch size 1024 将拆分为 4 个小 batch size,每个小 batch size 为 256 (1024/4)。
5 N J# `- W, t" I2 S' l 而如果 块 (或 GAS) 的数量为 32,我们最终得到的 micro batch size 为 8 (256/32)每个管级一次处理一个 micro batch计算 DP + PP 设置的全局批量大小的公式为: mbs * chunks * dp_degree (8 * 32 * 4 = 1024)。
- v+ L9 P8 f1 R9 `* L8 T+ X9 |1 ^# ` 我们回过头再看一下图使用 chunks=1 你最终得到的是朴素 PP,这是非常低效的而使用非常大的 块 数,你最终会得到很小的微批量大小,这很可能也不是很有效因此,必须通过实验来找到能最有效地利用 GPU 的 块数。 & ^0 ^0 C' Y$ a: x% ?/ ]
该图显示存在无法并行化的 “死” 时间气泡,因为最后一个 forward 阶段必须等待 backward 完成流水那么,找到最佳的 块 数,从而使所有参与的 GPU 达到高的并发利用率,这一问题其实就转化为最小化气泡数了。
; c4 X, D, q {" i, P* e# X 这种调度机制被称为 全前全后其他一些可选方案有 一前一后 和 交错一前一后一前一后方案: https://www.microsoft.com/en-us/research/publication/pipedream-generalized-pipeline-parallelism-for-dnn-training/ 。
! Q& o* Z- u4 S% {9 M 交错一前一后方案: https://arxiv.org/abs/2104.04473 虽然 Megatron-LM 和 DeepSpeed 都有自己的 PP 协议实现,但 Megatron-DeepSpeed 使用的是 DeepSpeed 实现,因为它与 DeepSpeed 的其他功能集成在一起。
3 y3 r7 w& ?, G 这里的另一个重要问题是词嵌入矩阵的大小虽然通常词嵌入矩阵比 transfomer 块所需的内存更少,但在 BLOOM 有 250k 词汇表的情况下,嵌入层需要 7.2GB 的 bf16 权重,而变换器块仅为 4.9GB。 ! a1 f8 D& m C9 @. w1 v/ Y2 s/ `0 x
因此,我们不得不让 Megatron-Deepspeed 将嵌入层视为一个转换器块所以我们有一个 72 级的流水线,其中 2 个是专门用于嵌入的 (第一个和最后一个)这使得我们可以平衡 GPU 的内存消耗。
- U# C% `- ]5 A 如果我们不这样做,我们就会让第一级和最后一级消耗很大的 GPU 内存,而 95% 的 GPU 内存使用会很少,因此训练将很不高效DP+PPDeepSpeed 流水线并行教程 中有一张图演示了如何将 DP 与 PP 结合起来,如下所示。
2 p' k$ a% {3 J `4 W( a 流水线并行教程:https://www.deepspeed.ai/tutorials/pipeline/ dp-pp-2d 这里重要的是要了解 DP rank 0 是看不见 GPU2 的, DP rank 1 是看不到 GPU3 的。 6 J; r2 Q4 y1 x
对于 DP 而言,只有 GPU 0 和 1,并向它们馈送数据GPU0 使用 PP “秘密地” 将它的一些负载卸载到 GPU2同样地, GPU1 也会得到 GPU3 的帮助由于每个维度至少需要 2 个 GPU,因此这儿至少需要 4 个 GPU。
+ b" F% u: c0 L DP+PP+TP为了更高效地训练,可以将 PP、TP 和 DP 相结合,称为 3D 并行,如下图所示dp-pp-tp-3d 此图来自博文《3D 并行: 扩展到万亿参数模型》), 这也是一篇好文章《3D 并行: 扩展到万亿参数模型》博文:。 + ~4 J5 f5 Q0 d( p ^2 j( k* G7 j
https://www.microsoft.com/en-us/research/blog/deepspeed-extreme-scale-model-training-for-everyone/ 由于每个维度至少需要 2 个 GPU,因此在这里你至少需要 8 个 GPU 才能实现完整的 3D 并行。 # o+ M4 o: }: ^/ ^6 p1 |: F- X% o! v
ZeRO DP+PP+TPDeepSpeed 的主要功能之一是 ZeRO,它是 DP 的超级可伸缩增强版,我们在 [ZeRO 数据并行](#ZeRO- 数据并行) 一节中已经讨论过了通常它是一个独立的功能,不需要 PP 或 TP。 9 ^& {" n$ a( u+ y0 b0 W; r4 D( y
但它也可以与 PP、TP 结合使用当 ZeRO-DP 与 PP (以及 TP) 结合时,它通常只启用 ZeRO 阶段 1,它只对优化器状态进行分片ZeRO 阶段 2 还会对梯度进行分片,阶段 3 也对模型权重进行分片。 3 y+ \4 j( N( G9 n6 a4 p, C
虽然理论上可以将 ZeRO 阶段 2 与 流水线并行 一起使用,但它会对性能产生不良影响每个 micro batch 都需要一个额外的 reduce-scatter 通信来在分片之前聚合梯度,这会增加潜在的显著通信开销。
5 V: _+ c; S2 Z 根据流水线并行的性质,我们会使用小的 micro batch ,并把重点放在算术强度 (micro batch size) 与最小化流水线气泡 (micro batch 的数量) 两者间折衷因此,增加的通信开销会损害流水线并行。 - u7 ^: y9 ] Z( i& c- a8 `
此外,由于 PP,层数已经比正常情况下少,因此并不会节省很多内存PP 已经将梯度大小减少了 1/PP,因此在此基础之上的梯度分片和纯 DP 相比节省不了多少内存ZeRO 阶段 3 也可用于训练这种规模的模型,但是,它需要的通信量比 DeepSpeed 3D 并行更多。
7 w6 x, m& n5 s# J' e 一年前,在对我们的环境进行仔细评估后,我们发现 Megatron-DeepSpeed 3D 并行性表现最佳此后,ZeRO 阶段 3 的性能有了显著提高,如果我们今天要对其进行重新评估,也许我们会选择阶段 3。 ' t" a+ U Q, X1 Q
BF16 优化器用 FP16 训练巨型 LLM 模型是一个禁忌我们已经通过花费几个月的时间训练 104B 模型自证了这一点,你可以从 Tensorboard 发现,彻头彻尾地失败了在与不断发散的 lm-loss 作斗争的过程中,我们学到了很多:。
# e) w: T( f: D8 V 训练 104B 模型代码: https://github.com/bigscience-workshop/bigscience/tree/master/train/tr8-104B-wide Tensorboard 文档: . w+ v( e* P( L* }1 S7 [& F
https://hf.co/bigscience/tr8-104B-logs/tensorboard 104B - 失败 我们也从 Megatron-LM 和 DeepSpeed 团队那里得到了相同的建议,在他们训得 530B 模型 后。
& ~; [- V2 g9 ^- d4 z0 B: S# F 最近发布的 OPT-175B 也报告说他们在 FP16 上训练得非常艰难530B 模型论文: https://arxiv.org/abs/2201.11990OPT-175B 论文: https://arxiv.org/abs/2205.01068 # ~1 \4 \: H3 ]/ G$ u
所以早在一月份,我们就知道我们要在支持 BF16 格式的 A100 上进行训练Olatunji Ruwase 开发了一个用来训练 BLOOM 的 “BF16Optimizer”如果您不熟悉这种数据格式,请查看它的位布局。
) j3 S7 O ?. Y1 w' U" ^. F% C8 h, \ BF16 格式的关键是它的指数位数与 FP32 相同,因此不会溢出,但 FP16 经常溢出!FP16 的最大数值范围为 64k,您只能进行较小数的乘法例如你可以做 250*250=62500,但如果你尝试 255*255=65025,你就会溢出,这是导致训练出现问题的主要原因。 * m/ [1 Y0 {5 ? m
这意味着你的权重必须保持很小一种称为损失缩放 (loss scaling) 的技术有助于缓解这个问题,但是当模型变得非常大时,FP16 较小的数值范围仍然是一个问题BF16 格式的位布局:https://en.wikipedia.org/wiki/Bfloat16_floating-point_format
; J. T0 [ A5 M, Z/ f BF16 没有这个问题,你可以很容易地做 10_000*10_000=100_000_000, 完全没问题当然,由于 BF16 和 FP16 的大小相同,均为 2 个字节,因此,没有免费的午餐,当使用 BF16 时,代价就是它的精度非常差。
% m C8 k. U, d% I5 p/ k2 } 然而,你应该还记得我们在训练时采用的随机梯度下降法及其变体,该方法有点像蹒跚而行,如果你这步没有找到完美的方向其实没关系,你会在接下来的步骤中纠正自己无论使用 BF16 还是 FP16,都有一个权重副本始终在 FP32 中 —— 这是由优化器更新的内容。 2 K2 H) s) D: `+ b
因此 16 位格式仅用于计算,优化器以全精度更新 FP32 权重,然后将它们转换为 16 位格式以用于下一次迭代所有 PyTorch 组件都已更新,以确保它们在 FP32 中执行任何累加,因此不会发生精度损失。
1 Y* \! }% p: X 一个关键问题是梯度累积,它是流水线并行的主要特征之一,因为每个 micro batch 处理的梯度都会累积在 FP32 中实现梯度累积以保证训练的精确性至关重要,这正是 BF16Optimizer 所做的。
: w5 S E; h5 m- a 除了其他改进之外,我们认为使用 BF16 混合精度训练将潜在的噩梦变成了一个相对平稳的过程,这可以从以下 lm 损失图中看出:176B - 损失 CUDA 融合核函数GPU 主要做两件事它可以将数据写到显存或从显存读数据,并对这些数据执行计算。 5 j4 ?) ~) n1 d/ g0 Y
当 GPU 忙于读写数据时, GPU 的计算单元就会空闲如果我们想有效地利用 GPU,我们希望将空闲时间降至最低核函数是一组实现特定 PyTorch 操作的指令例如,当你调用 torch.add 时,它会通过一个 PyTorch 调度器,它会根据输入张量及其他变量的取值来决定它应该运行哪些代码,最后运行它。
- h1 E4 | f0 | k6 s2 X CUDA 核函数使用 CUDA 来实现这些代码,因此只能在 NVIDIA GPU 上运行PyTorch 调度器:http://blog.ezyang.com/2020/09/lets-talk-about-the-pytorch-dispatcher/ 8 j% C9 ^( L- V' q* ^
现在,当使用 GPU 计算 c = torch.add (a, b); e = torch.max ([c,d]) 时,一般情况下,PyTorch 将执行的操作是启动两个单独的核函数,一个执行 a 和 b 的加法,另一个执行取 c 和 d 两者的最大值。 7 l& J8 M M* {9 X. P4 [$ ~* B: s
在这种情况下,GPU 从其显存中获取 a 和 b,执行加法运算,然后将结果写回显存然后它获取 c 和 d 并执行 max 操作,然后再次将结果写回显存如果我们要融合这两个操作,即将它们放入一个 “融合核函数” 中,然后启动那个内核,我们不会将中间结果 c 写到显存中,而是将其保留在 GPU 寄存器中,并且仅需要获取 d 来完成最后的计算。 2 M) e1 n. V' g3 N, a5 T$ z
这节省了大量开销并防止 GPU 空闲,因此整个操作会更加高效融合核函数就是这样它们主要将多个离散的计算和进出显存的数据移动替换为有很少数据移动的融合计算此外,一些融合核函数会对操作进行数学变换,以便可以更快地执行某些计算组合。
8 r& \) A; U4 L/ O. F4 G; B 为了快速高效地训练 BLOOM,有必要使用 Megatron-LM 提供的几个自定义 CUDA 融合核函数特别地,有一个 LayerNorm 的融合核函数以及用于融合缩放、掩码和 softmax 这些操作的各种组合的核函数。
4 {( H' |9 B- q4 V+ L& F# I* | r Bias Add 也通过 PyTorch 的 JIT 功能与 GeLU 融合这些操作都是瓶颈在内存的,因此将它们融合在一起以达到最大化每次显存读取后的计算量非常重要因此,例如,在执行瓶颈在内存的 GeLU 操作时同时执行 Bias Add,运行时间并不会增加。
1 q+ w% q H; V( T6 n 这些核函数都可以在 Megatron-LM 代码库 中找到数据集Megatron-LM 的另一个重要特性是高效的数据加载器在首次训练启动前,每个数据集中的每个样本都被分成固定序列长度 (BLOOM 为 2048) 的样本,并创建索引以对每个样本进行编号。 ! }. K4 J+ U/ c: D2 X) y. a; U
基于训练超参,我们会确定每个数据集所需要参与的 epoch 数,并基于此创建一个有序的样本索引列表,然后打乱它举个例子,如果一个数据集中有 10 个样本并应参与 2 个 epoch 的训练,则系统首先按 [0, ..., 9, 0, ..., 9] 顺序排好样本索引,然后打乱该顺序为数据集创建最终的全局顺序。 * G+ [" P6 ^2 F# P
请注意,这意味着训练不会简单地遍历整个数据集然后重复,你有可能在看到另一个样本之前看到同一个样本两次,但在训练结束时模型将只看到每个样本两次这有助于确保整个训练过程中的训练曲线平滑这些索引,包括每个样本在原始数据集中的偏移量,被保存到一个文件中,以避免每次开始训练时都重新计算它们。 2 D; y/ X* t5 w' B' ~3 i7 y
最后,可以将其中几个数据集以不同的权重混合到训练最终使用的数据中嵌入 LayerNorm在我们努力阻止 104B 模型发散的过程中,我们发现在第一个层词嵌入层之后添加一个额外的 LayerNorm 可以使训练更加稳定。
& I) U/ G$ F& d" }9 P# j 该洞察来自对 bitsandbytes 的实验,bitsandbytes 有一个 StableEmbedding 操作,它是一个带有 LayerNorm 的普通嵌入,其使用均匀 xavier 函数来初始化。
$ u0 U) b. j7 E- o$ e bitsandbytes 代码仓库:https://github.com/TimDettmers/bitsandbytes 位置编码基于论文 Train Short, Test Long: Attention with Linear Biases Enables Input Length Extrapolation,我们还用 AliBi 替换了普通的位置嵌入,它允许外推比训练模型的输入序列更长的输入序列。 ' M$ c# H& T" h7 r$ ?
因此,即使我们训练时使用长度为 2048 的序列,模型也可以在推理过程中处理更长的序列Train Short, Test Long: Attention with Linear Biases Enables Input Length Extrapolation: 1 ?/ G5 t7 G( Z4 U
https://arxiv.org/abs/2108.12409 训练中的困难随着架构、硬件和软件的就位,我们得以在 2022 年 3 月上旬开始训练然而,从那时起,事情其实并非一帆风顺在本节中,我们将讨论我们遇到的一些主要障碍。
6 E) E& E& l% J7 H0 V0 V! o 在训练开始之前,有很多问题需要弄清楚特别是,我们发现了几个问题,这些问题只有在我们开始在 48 个节点上进行训练后才会出现,而不会在小规模时出现例如,需要设 CUDA_LAUNCH_BLOCKING=1 来防止框架挂起,我们需要将优化器组分成更小的组,否则框架会再次挂起。
6 e5 b5 [8 b1 ]& V" C 你可以在 训前编年史 中详细了解这些内容训前编年史: https://github.com/bigscience-workshop/bigscience/blob/master/train/tr11-176B-ml/chronicles-prequel.md
! q3 i M& t% ]. }8 F6 H% z8 y 训练期间遇到的主要问题类型是硬件故障由于这是一个拥有大约 400 个 GPU 的新集群,平均每周我们会遇到 1-2 个 GPU 故障我们每 3 小时 (100 次迭代) 保存一个检查点因此,我们每周因硬件崩溃平均损失 1.5 小时的训练成果。
! B. J$ d( L1 I# n( h Jean Zay 系统管理员随后将更换有故障的 GPU 并恢复节点与此同时,我们有备用节点可供使用我们还遇到过多次导致 5-10 小时停机的各种其他问题,其中一些与 PyTorch 中的死锁错误有关,另一些则是由于磁盘空间不足。
; `9 |1 m4 M7 y/ F7 L 如果您对具体细节有兴趣,请参阅 训练编年史训练编年史: https://github.com/bigscience-workshop/bigscience/blob/master/train/tr11-176B-ml/chronicles.md - B: T: |$ i& c; T* h% f# O( H' v
在对训练这个模型进行可行性分析时,所有这些停机时间都被计划在内了,我们也据此选择了合适的模型大小和我们希望模型消耗的数据量因此,即使存在这些停机问题,我们还是成功地在预计时间内完成了训练如前所述,它需要大约 100 万个计算时才能完成。
9 H' ~4 _: ]8 m 另一个问题是 SLURM 并非设计为供一组人使用SLURM 作业由单个用户拥有,如果他们不在身边,则该组的其他成员无法对正在运行的作业执行任何操作我们制定了一个终止方案,允许组中的其他用户终止当前进程,而不需要启动该进程的用户在场。
% X9 `) X( j' f6 M 这在 90% 的问题上都很有效如果 SLURM 设计者读到这篇文章,请添加一个 Unix 组的概念,这样一个 SLURM 作业就可以由一个组拥有由于训练是全天候 24/7 进行的,我们需要有人随叫随到 - 但由于我们在欧洲和加拿大西海岸都有人,因此不需要有人携带传呼机,我们能很好地互相备份。
& _& b( n* P8 b$ { 当然,周末的训练也得有人看着我们自动化了大部分事情,包括自动从硬件崩溃中恢复,但有时仍需要人工干预结论训练中最困难和最紧张的部分是训练开始前的 2 个月我们承受着尽快开始训练的巨大压力,因为资源分配的时间有限,我们直到最后一刻才接触到 A100。
) X. r$ J1 }) k$ {; x 所以这是一个非常困难的时期,考虑到 BF16Optimizer 是在最后一刻编写出来的,我们需要调试它并修复各种 bug正如上一节所述,我们发现了新问题,这些问题只有在我们开始在 48 个节点上进行训练后才会出现,并且不会在小规模时出现。
' x% `9 |2 b6 f1 p 但是一旦我们把这些整理完,训练本身出奇的顺利,没有出现大的问题大多数时候,我们只有一个人看着,只有少数几个人参与故障排除我们得到了 Jean Zay 管理部门的大力支持,他们迅速解决了训练期间出现的大部分需求。
8 T) i, f) k" R+ _ 总的来说,这是一次超级紧张但回报颇丰的经历训练大型语言模型仍然是一项具有挑战性的任务,但我们希望通过公开构建和共享这项技术,其他人可以借鉴我们的经验资源重要链接主训练文档 https://github.com/bigscience-workshop/bigscience/blob/master/train/tr11-176B-ml/README.md。 9 w. v; N) c0 T3 q d
Tensorboard https://huggingface.co/bigscience/tr11-176B-ml-logs/tensorboard 训练用的 slurm 脚本 https://github.com/bigscience-workshop/bigscience/blob/master/train/tr11-176B-ml/tr11-176B-ml.slurm
% q4 S9 Y2 K5 Q" f* K 论文与文章我们不可能在本文中详细解释所有内容,因此如果此处介绍的技术激起你的好奇心,使你想了解更多信息,请阅读以下论文:Megatron-LM:Efficient Large-Scale Language Model Training on GPU Clusters.
( \4 [+ M" U5 B) Y https://arxiv.org/abs/2104.04473 Reducing Activation Recomputation in Large Transformer Models https://arxiv.org/abs/2205.05198
" O' G9 G4 y/ {' W DeepSpeed:ZeRO: Memory Optimizations Toward Training Trillion Parameter Models https://arxiv.org/abs/1910.02054
5 s D% O: H2 b' } ZeRO-Offload: Democratizing Billion-Scale Model Training https://arxiv.org/abs/2101.06840 ZeRO-Infinity: Breaking the GPU Memory Wall for Extreme Scale Deep Learning $ ?7 L1 ^+ {7 r& K8 x) Z) J
https://arxiv.org/abs/2104.07857 DeepSpeed: Extreme-scale model training for everyone https://www.microsoft.com/en-us/research/blog/deepspeed-extreme-scale-model-training-for-everyone/ 6 N+ l& L7 M" E- K
Megatron-LM 和 Deepspeeed 联合:Using DeepSpeed and Megatron to Train Megatron-Turing NLG 530B, A Large-Scale Generative Language Model.
) f# ~( ?$ \9 l( r' p" z! j0 g f https://arxiv.org/abs/2201.11990 ALiBi:Train Short, Test Long: Attention with Linear Biases Enables Input Length Extrapolation
' C) y8 Z9 d9 s5 r7 h https://arxiv.org/abs/2108.12409 What Language Model to Train if You Have One Million GPU Hours? - 你会在那里找到最终使得我们选择 ALiBi 的实验。 / I4 P9 E* \5 D* B( A" H+ R+ V
https://openreview.net/forum?id=rI7BL3fHIZq BitsNBytes:8-bit Opti mizers via Block-wise Quantization (我们使用了该论文中的嵌入 LaynerNorm,但是论文的其他部分及其技术也很妙,我们没用 8 位优化器的唯一原因是我们已经使用 DeepSpeed-ZeRO 节省了优化器内存)。 ) ]7 D# I4 B) @' x' T# {7 y# [& \6 @
https://arxiv.org/abs/2110.02861 博文致谢非常感谢以下这些人,他们提出了很好的问题并帮助提高了文章的可读性 (按字母序):Britney Muller, Douwe Kiela, , ^ `4 U* d: [. m
Jared Casper, Jeff Rasley, Julien Launay, Leandro von Werra, Omar Sanseviero, Stefan Schweter and Thomas Wang. U) v) |- b% [2 E i1 b6 Z% j
本文图表主要由 Chunte Lee 创作英文原文:https://hf.co/blog/bloom-megatron-deepspeed 原文作者: Stas Bekman译者: Matrix Yao (姚伟峰),英特尔深度学习工程师,工作方向为 transformer-family 模型在各模态数据上的应用及大规模模型的训练推理。
t" g+ k; }0 Y 审校、排版: zhongdongy (阿东)END卡巴斯基实锤拼多多APP恶意代码 OSC开源社区 ,赞 50 这里有最新开源资讯、软件更新、技术干货等内容点这里 ↓↓↓ 记得 关注✔ 标星⭐ 哦返回搜狐,查看更多
# E" B# X9 E/ H- R6 e- C 责任编辑: , b* R* ~8 w& j: ]5 t0 e3 f
8 ^+ Q0 v$ h% P/ B) p8 P" P9 p/ p* c9 z- d( i q5 v
/ P: P1 M1 Z% L. R
& p4 H8 q7 z8 n" A; e
| 


